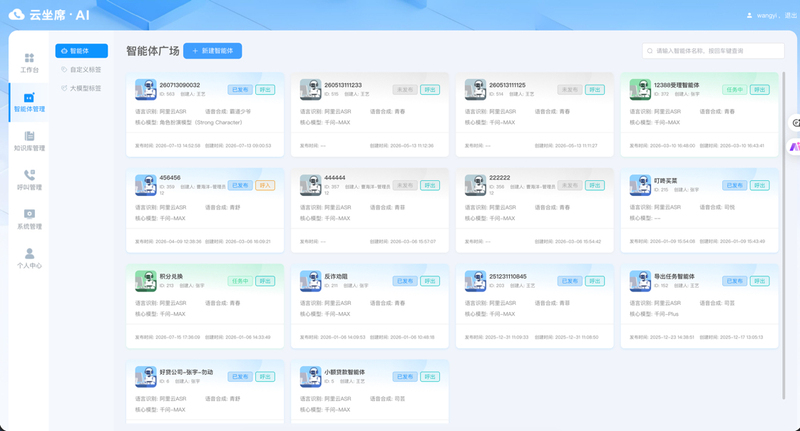
本项目用在智能语音外呼和客服场景,是"大模型语音智能体"平台的知识库子系统。在金融催收、电商回访、政务咨询这类业务里,AI
坐席要能准确回答产品政策、业务规则和常见问题。但通用大模型不了解企业的私有知识,容易答错,也就是"幻觉"。同时,平台给多家企业租户共用,每家的知识必须严格隔开。所以我们基于
RAG(检索增强生成)做了这个多租户企业知识库:企业把自己的文档和问答资料上传进来,AI 智能体通话时先检索知识库,再根据检索到的内容生成回答,让回答准确、专业、可追溯。
- 知识库管理:新建、编辑、删除、查询知识库,支持一键复制知识库。每个租户管理自己的多个知识库,按业务线分开维护。
- 文档管理与解析:支持 PDF、Word、TXT 等多种格式上传,也可以直接录入自定义文本。还支持 Excel
问答对批量导入,每行问答自动拼成一个知识片段。分段方式有三种:按段落智能分段、强制按段落分段、按自定义分隔符分段。文档在后台异步解析,前端能实时看到进度条,解析失败可以一键重试。
- 分段(Chunk)管理:分页查看每个文档切出来的片段,可以手动新增、修改或删除片段。修改后会自动重新计算向量,人工校正知识内容后马上生效。
- 检索与问答:支持纯向量检索,方便调试和验证召回效果;也支持知识库问答,可以同时指定多个知识库,设置 TopK、相似度阈值、文档类型过滤,还能自定义系统提示词并选择模型。问答支持多轮对话,能记住上下文;支持 SSE
流式输出,先返回"参考来源"片段,再逐字推送回答。
架构与技术栈:这是一个独立的 Spring Cloud 微服务,基于 Spring Boot 2.5 和 Java 8,通过 Nacos 做服务注册和配置中心,由网关统一对外提供接口。主要组件:
- 文档解析用 Apache Tika,Excel 解析用 POI;
- 文本切分用 LangChain4j;
- 中文向量化用 bge-base-zh-v1.5 模型,通过 infinity-emb 部署,输出 768 维向量;
- 向量存储与检索用 Milvus,索引类型 IVF_FLAT,相似度算法为余弦相似度;
- 大模型调用对接 Ollama 等,支持切换模型;
- 业务数据存在 MySQL,用 MyBatis-Plus 操作;会话历史存在 Redis;原始文件存在 MinIO。
整体流程:文档解析 → 切分 → 向量化 → 写入 Milvus;提问时把问题向量化 → 在 Milvus 中做相似度检索 → 把检索结果拼成上下文 → 交给大模型生成回答。
亮点与难点:
1. 多租户向量隔离:每个租户在 Milvus 里单独一个 collection(命名为 rag_tenant_{id}),首次使用时自动创建,从存储层面隔开不同企业的数据。检索时再叠加知识库 ID、文档
ID、文档类型等标量条件过滤,一次查询就能限定在指定的几个知识库内。
2. 大文件异步解析与实时进度:上传接口立即返回,解析和向量化交给专用线程池(核心 5 个、最多 20 个线程,队列满时由调用线程自己执行,起到限流作用)。向量化改成逐段处理、逐段入库,一方面降低内存峰值,另一方面
能准确算出"已处理/总段数",给前端轮询展示进度。数据库里的文档状态(处理中/成功/失败)作为最终结果,失败可以重试。
3. 灵活的切分策略:默认每段最多 500 字、相邻段重叠 100 字,避免语义被切断。可选"强制段落"模式,让每个短段落单独成段,不和相邻段合并,适合 FAQ 类文档;超长段落会再按长度二次切分。也可以按自定义分隔符切分。
4. 多轮对话记忆:用 Redis List 按会话 ID 保存历史,采用滑动窗口只保留最近 10 轮,控制提示词长度。流式回答全部结束后才写入历史,避免中途异常把不完整的回答存进记忆。
5. 流式问答体验:通过 SSE 先推送检索到的参考片段,再按 token 逐步推送大模型的输出,明显缩短首字响应时间,适合语音场景的实时性要求。
6. 知识可人工干预:可以直接增删改单个片段,修改后自动重新计算向量,不用重新上传整份文档就能修正知识。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论