1、立项原因:代码评审是研发质量的关键闸门,但人工评审普遍面临"文件多、时间紧、规则不一致"的困境——一次变更动辄数百个文件,评审人难以逐行通读,缺陷容易漏检;中小团队与开源项目更缺少专职评审人,质量高度依赖少数核心维护者的经验,形成明显的评审瓶颈。大模型虽具备代码理解力,直接拿来当工具却存在两个产品问题:单轮对话承载不了整仓上下文,模型不了解项目架构与业务背景,建议泛泛而谈、难以落地;长链路调用不稳定,超时、限流、输出格式非法都会让评审中断,且过程不可见、失败只能整任务重跑。本项目立项,就是为了填平"大模型能看懂代码"到"可稳定交付的评审服务"之间的工程鸿沟。
2、行业场景业务背景:核心场景是研发团队日常的 PR 评审与开源仓库维护。开发者希望在提测、合并前用一条命令或一次点击,拿到按严重程度分级、带代码定位的评审报告,把注意力从"找问题"转向"判断问题";团队希望评审过程可观测、可留痕、可复用,而不是散落在各人的聊天记录里。随着 AI 辅助编程普及,代码产出速度明显加快,评审环节正在成为新的交付瓶颈,自动化代码评审正从"尝鲜工具"变成"团队刚需"。
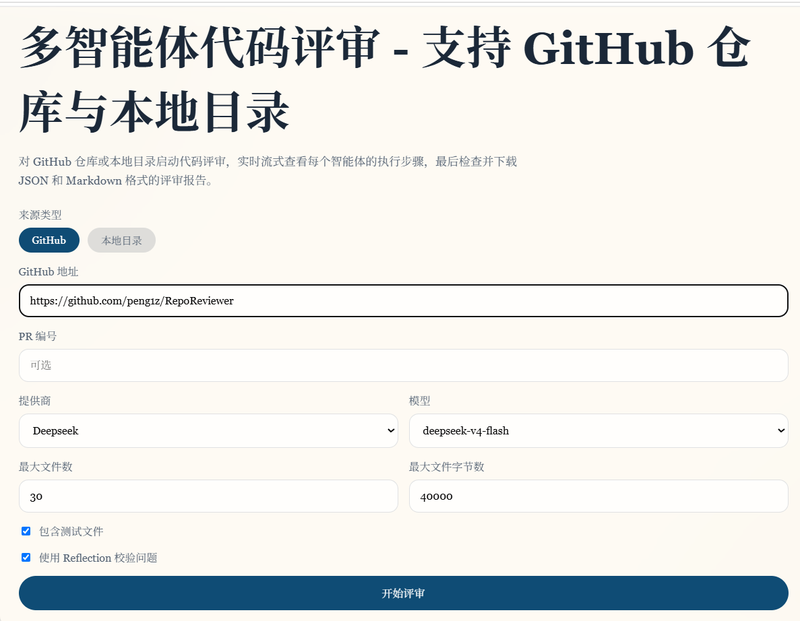
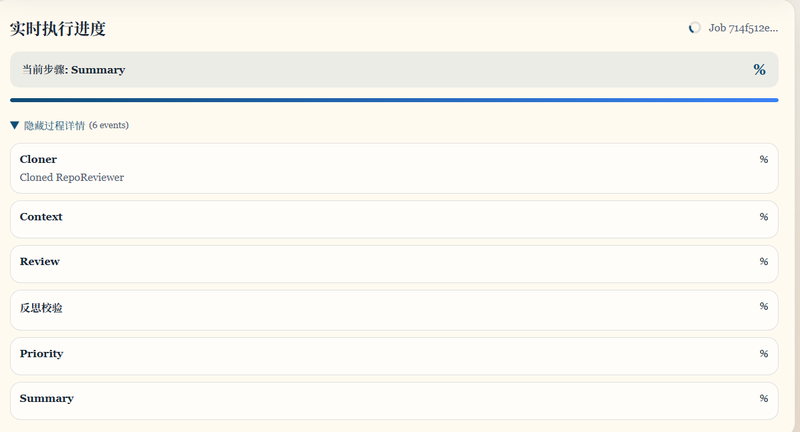
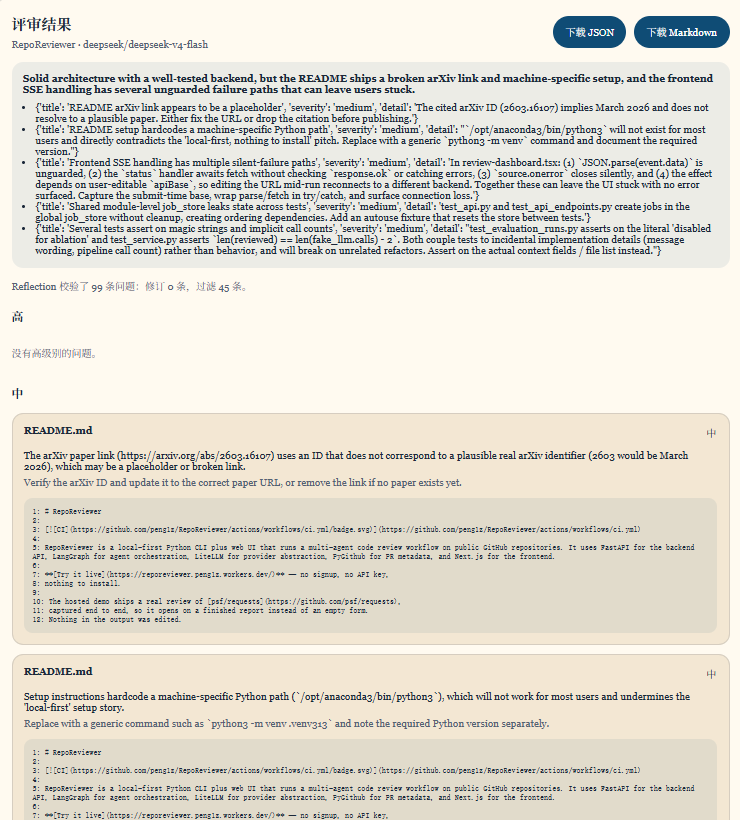
1、具体功能模块:①多源输入模块,支持 GitHub 仓库、PR 变更集(PyGithub 拉取变更文件)与本地目录三类评审对象;②模型接入模块,统一封装 6 类提供商(OpenAI、Anthropic、DeepSeek、OpenRouter、Groq、Ollama),前端可按提供商动态加载候选与默认模型;③六阶段 Agent 流水线,克隆→上下文构建→文件评审→反思校验→优先级排序→总结;④任务与状态模块,SQLite 持久化任务及每个阶段的状态、耗时、错误与重试记录;⑤实时进度模块,SSE 推送阶段事件;⑥报告模块,输出 review.json 与 review.md 并支持下载;⑦Web 工作台,表单提交、本地目录浏览、实时进度与报告渲染,支持中英文界面。
2、主要功能描述:用户提交仓库地址或选择本地目录后,系统先按 ignore 规则、文件大小与扩展名白名单过滤噪声文件,再按优先级选出最值得评审的文件;随后用固定预算采样生成项目上下文摘要,并注入每个文件的评审提示词,让模型在了解项目框架的前提下逐文件产出问题描述、修改建议、严重程度与代码行号;反思校验阶段对已有结论做保留、修订或剔除的二次验证;优先级阶段用确定性代码去重排序;最终生成分级报告,可导出 JSON/Markdown。长链路执行全程在前端可见每个阶段的进度与耗时;任务被持久化,LLM 阶段支持自动重试,失败任务可从失败点断点续跑,服务重启不丢任务。
1、我负责的任务:独立完成从原型到可用产品的全流程。①设计并实现 LangGraph 六阶段评审流水线,定义共享状态在节点间的传递契约;②重构任务系统,抽象 workflow/service/persistence/job_store 四层,落地任务状态机、阶段级状态追踪、SSE 事件流与断点续跑;③实现仓库扫描与评审前过滤:ignore 规则、大小与扩展名白名单、优先级打分;④实现 LiteLLM 统一模型接入层与输出兜底解析;⑤补齐本地目录评审能力,完成路径规范化、白名单根校验与路径穿越防护;⑥编写并维护后端测试,55 个用例全部通过。
2、技术栈与架构:后端 Python 3.12 + FastAPI + Pydantic v2 + Typer,编排 LangGraph,模型接入 LiteLLM,GitHub 集成 PyGithub,存储 SQLite,进度推送 SSE;前端 Next.js 15 + React 19 + TypeScript。核心架构是"业务与生命周期分离":workflow.py 只管如何评审,不含持久化与重试代码;service.py 管状态机、重试与恢复;persistence.py 是纯 SQL 层;job_store.py 是适配器,便于换存储、注入内存库测试。
亮点与难点:①长链路稳定性——重试只开放给可能临时失败的 LLM 阶段且上限一次,确定性错误快速失败,失败时统一收口未完成阶段,杜绝"任务完成但阶段悬空";②模型输出容错——提取 JSON、逐阶段降级兜底、强类型校验三道防线,越靠近终点降级越体面;③可观测性——阶段边界由进度事件推断,workflow 不感知数据库;④安全——本地路径先规范化再校验白名单,同名文件夹消歧只有在得分严格领先时才给推荐,宁可不猜不错。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态








评论