

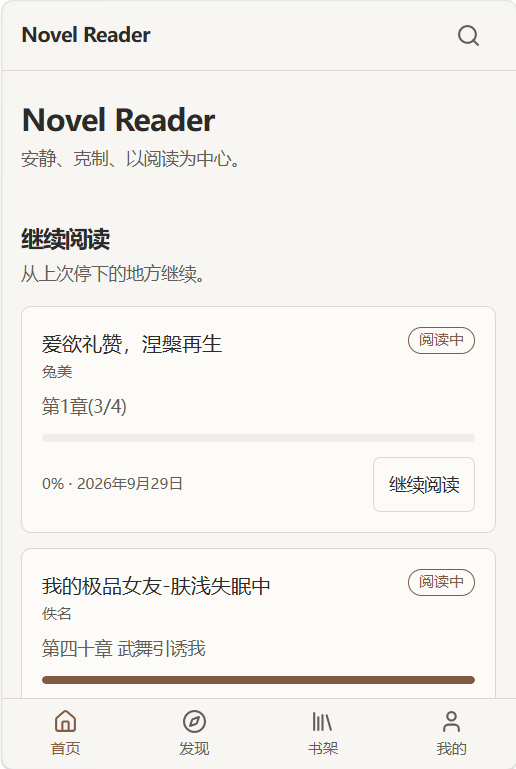
网文数字阅读行业:海量文本内容的自动化采集入库、结构化清洗、分类检索与在线阅读分发。适用于内容站点快速建库、大数据量文本平台搭建、低资源成本下的高并发内容运营。


点击空白处退出提示



网文数字阅读行业:海量文本内容的自动化采集入库、结构化清洗、分类检索与在线阅读分发。适用于内容站点快速建库、大数据量文本平台搭建、低资源成本下的高并发内容运营。
1. 海量书库:21.4 万本、7776 万章节(约 466GB 文本),支持书名/作者全文检索
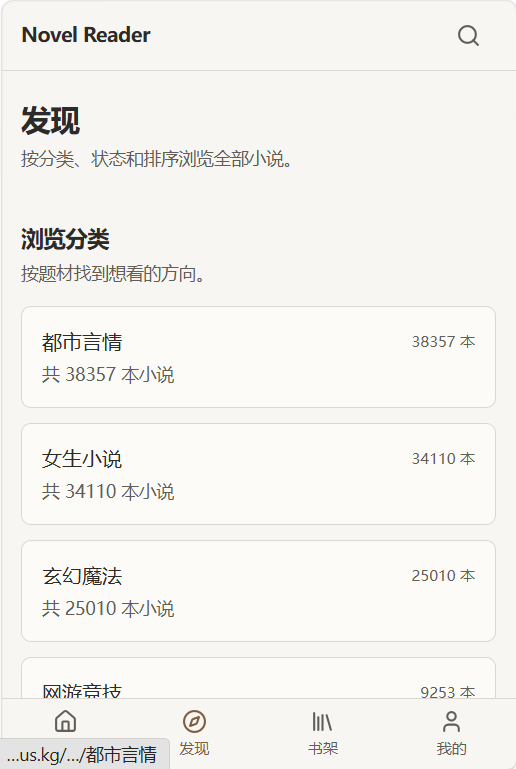
2. 精细分类:48 个品类导航(玄幻/都市/言情/历史/科幻等一级分类 + 41 个细分品类),支持完结状态、字数、更新时间多维筛选
3. 在线阅读器:手势翻页、字号/主题切换、阅读进度记忆与书架同步
4. 用户系统:注册登录、书架收藏、阅读历史
5. 内容分级过滤:分级内容仅搜索可见、不进入首页与分类流,新入库内容自动识别分级
6. 管理后台:书籍/章节/分类管理 + 实时吞吐监控(QPS、来源统计、错误率,30 秒自动刷新)
架构:Next.js 16(App Router,SSR + ISR)前端 + FastAPI 后端 + MySQL 8 存储 + Nginx 反向代理 + Cloudflare CDN,Windows Server 单机部署,计划任务托管进程。
核心实现:
- 大数据量优化:单表 7776 万行章节(466GB),通过唯一索引/外键优化、Buffer Pool 调优、批量导入幂等设计,在 24GB 内存服务器上实现低资源稳定运行
- 数据管道:批量导入 zip/txt → 章节解析去重 → 首章异常修复(批量修正 335 万条标题)→ 关键词分类器自动归类 → 完结状态识别,全流程幂等可重跑
- 监控链路:Nginx 日志 → awk 聚合 → 内网上报 API → 实时监控页,为动态限速提供数据支撑
- 成本控制:单机部署 + Cloudflare 分层缓存(静态资源长缓存、接口按需回源),显著降低源站压力与带宽成本

评论