

面向视频内容平台的数据采集与热度分析场景。项目针对哔哩哔哩热门榜单中不同分区的视频数据进行自动化采集,解决人工查看榜单效率低、历史变化难以持续记录、不同分区热度缺乏统一统计的问题。系统可定期获取全站、动画、游戏、知识等分区的热门视频信息,对播放量、弹幕数、排名及互动情况进行结构化整理,并通过历史快照对比观察播放增长和榜单排名变化。适用于内容趋势研究、热门视频追踪、自媒体选题辅助、竞品内容观察以及视频平台公开数据分析等场景


点击空白处退出提示
 1


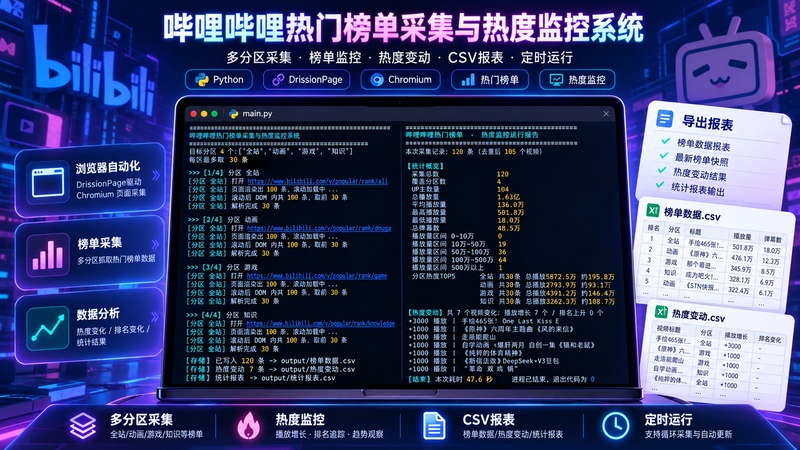
面向视频内容平台的数据采集与热度分析场景。项目针对哔哩哔哩热门榜单中不同分区的视频数据进行自动化采集,解决人工查看榜单效率低、历史变化难以持续记录、不同分区热度缺乏统一统计的问题。系统可定期获取全站、动画、游戏、知识等分区的热门视频信息,对播放量、弹幕数、排名及互动情况进行结构化整理,并通过历史快照对比观察播放增长和榜单排名变化。适用于内容趋势研究、热门视频追踪、自媒体选题辅助、竞品内容观察以及视频平台公开数据分析等场景
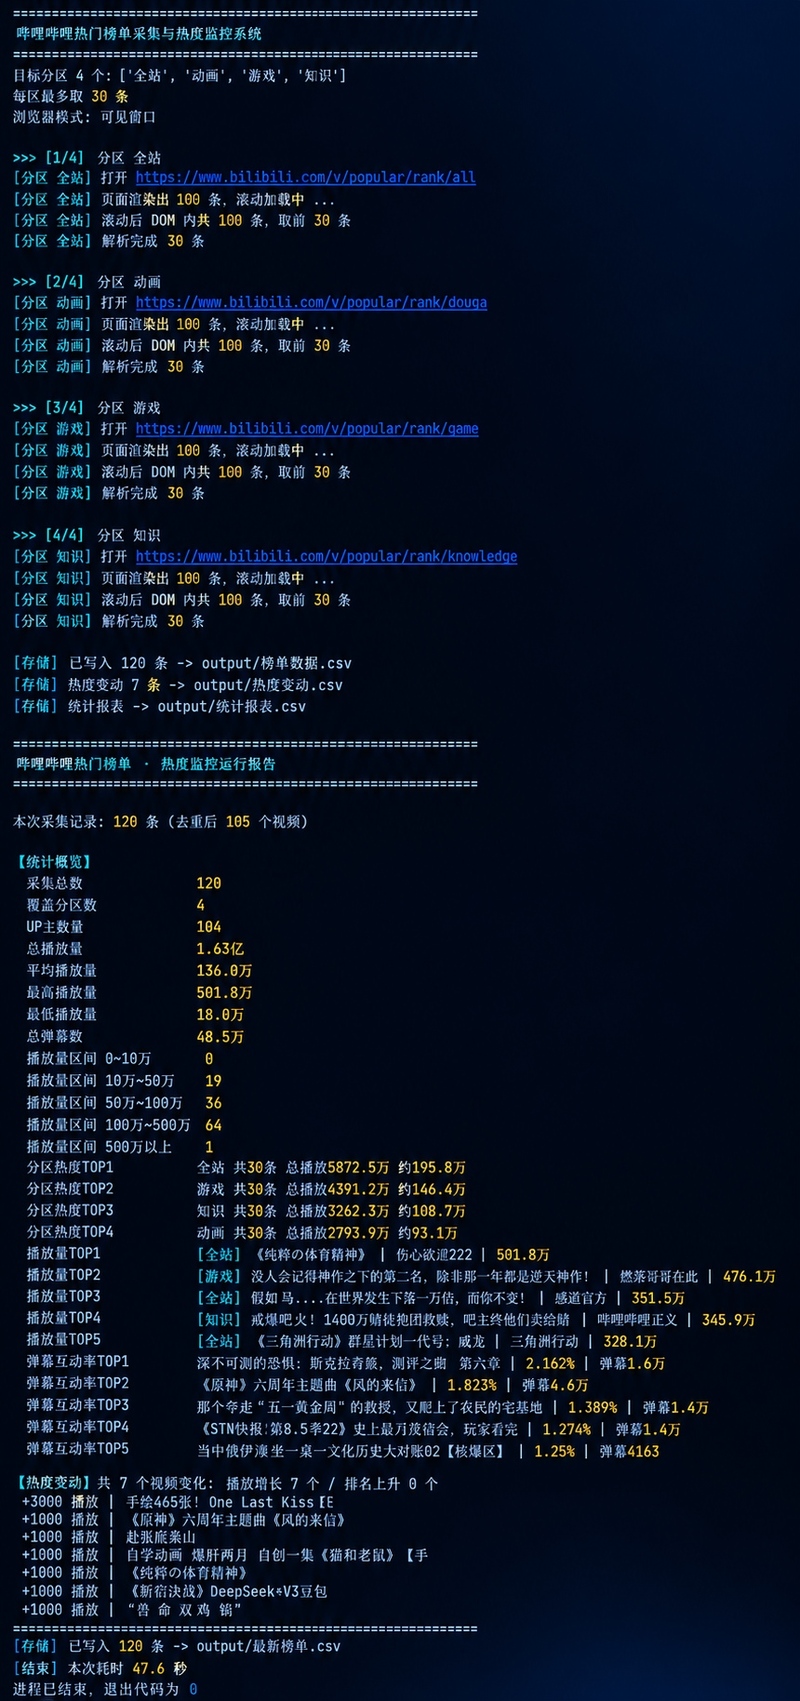
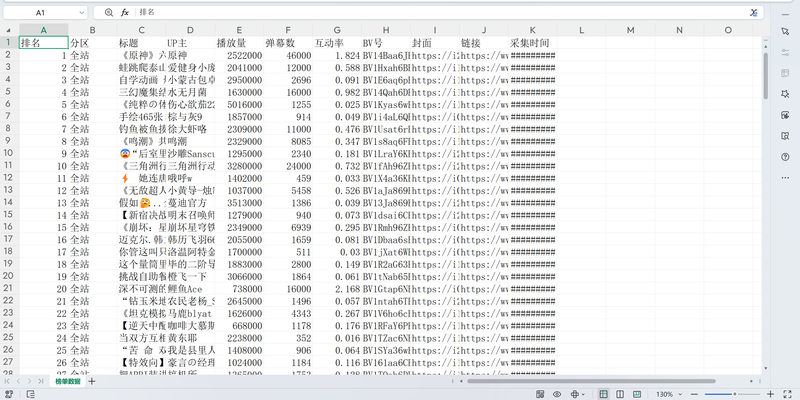
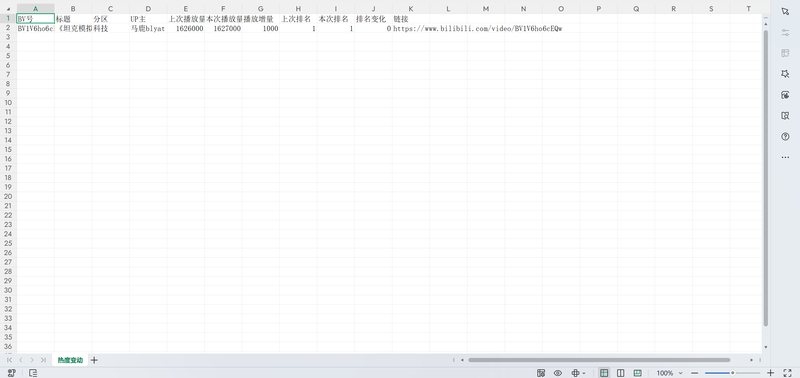
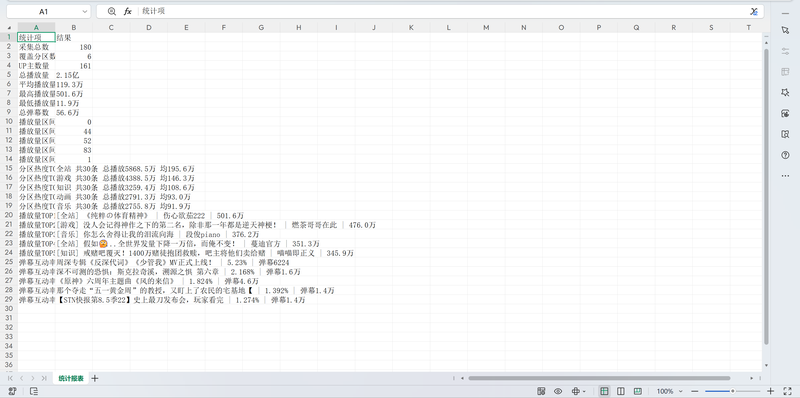
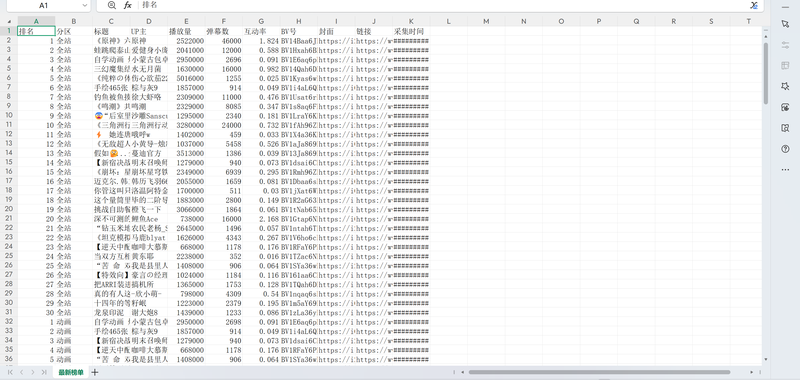
系统支持哔哩哔哩多个热门榜单分区的批量数据采集,可获取视频排名、分区、标题、UP主、播放量、弹幕数、互动率、BV号、封面、视频链接和采集时间等字段。支持浏览器自动化访问、动态页面等待和滚动加载,并将采集结果统一保存为 CSV 文件。系统能够对本次榜单与上一次历史快照进行比较,计算视频播放增量和排名变化,并生成热度变动报表。同时提供采集总数、覆盖分区数、UP主数量、总播放量、平均播放量、播放量区间、分区热度 TOP、播放量 TOP 以及弹幕互动率 TOP 等统计结果。支持定时循环采集、无头浏览器运行、指定采集分区和单分区采集数量等参数配置。
项目使用 Python 开发,核心浏览器自动化部分采用 DrissionPage 驱动 Chromium,对哔哩哔哩热门榜单页面进行访问和数据提取。程序首先根据配置进入指定榜单分区,等待页面动态渲染完成,通过 DOM 中榜单元素数量判断数据是否加载稳定,再执行页面滚动以确保榜单内容完整加载。随后解析每个视频卡片中的标题、UP主、播放量、弹幕数、BV号、封面及链接,并对“万”“亿”等展示格式进行数值标准化,同时计算弹幕互动率。采集结果通过 CSV 持久化保存,并以“分区 + BV号”作为记录标识,对当前数据与历史快照进行比较,实现播放增量和排名变化计算。项目还实现了数据去重、统计汇总、异常捕获、页面关闭、定时循环任务和命令行参数控制,可通过参数指定分区、采集数量、运行周期及无头模式,形成从采集、清洗、存储、对比到统计分析的完整流程。

评论