

企业内部的制度文件、产品手册、常见问题文档分散在各处,员工和客户经常重复询问同样的问题,人事、客服人员需要反复人工解答,而且回答口径不统一。本项目把企业文档变成可以用自然语言提问的知识库,适用于企业内部制度问答、产品售后客服、新员工培训答疑等场景。演示数据为一份虚构的《员工手册》(考勤休假、报销差旅)。

点击空白处退出提示
企业内部的制度文件、产品手册、常见问题文档分散在各处,员工和客户经常重复询问同样的问题,人事、客服人员需要反复人工解答,而且回答口径不统一。本项目把企业文档变成可以用自然语言提问的知识库,适用于企业内部制度问答、产品售后客服、新员工培训答疑等场景。演示数据为一份虚构的《员工手册》(考勤休假、报销差旅)。
1、文档导入:支持 Markdown、TXT、PDF、Word 文档,放入目录后自动切分、建立索引,兼容 GBK 编码的中文文档。
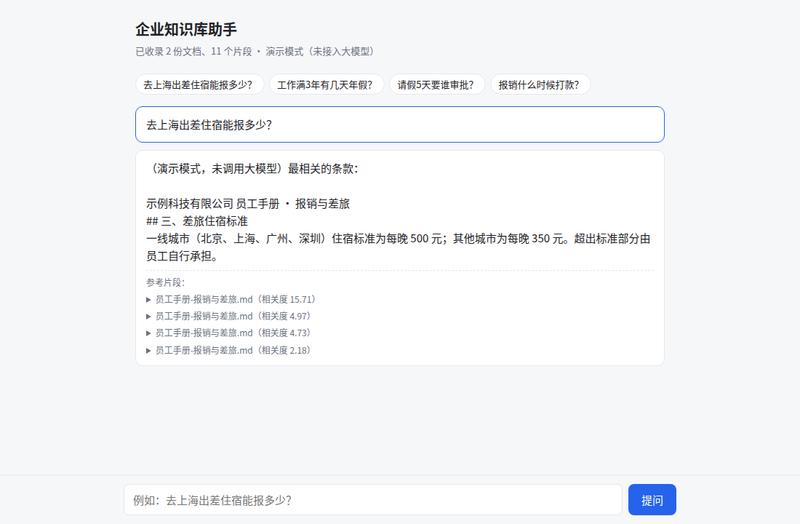
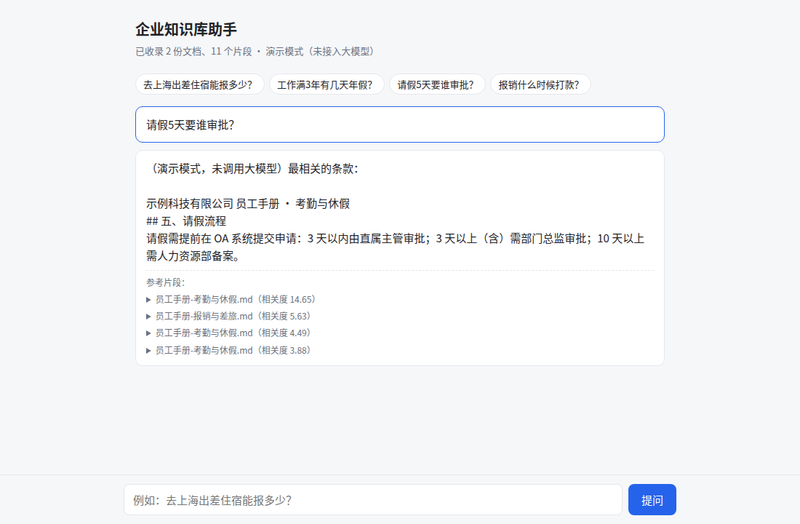
2、中文检索:基于 BM25 算法,采用单字加二元组切词,不需要向量数据库和 GPU;相关度低于阈值的问题直接回答“知识库中没有找到相关规定”,避免编造。
3、大模型问答:接入 DeepSeek、通义千问、Kimi 等 OpenAI 兼容接口,根据检索到的条款生成回答;未配置密钥时可进入演示模式。
4、引用溯源:每条回答附带原文片段、来源文件和相关度,便于核对。
5、网页界面:示例问题一键提问,支持通过链接直接提问,适配手机和深色模式。
6、部署:单文件后端、无必需依赖,提供 Dockerfile,可私有化部署在企业内网。
使用 AI 编程工具(Claude Code)完成需求设计、编码和测试,属于 Vibe Coding 项目。技术栈:Python 标准库 http.server 后端、原生 HTML/JavaScript 前端、BM25 检索、OpenAI 兼容的大模型接口、Docker。实现亮点:不依赖分词库和向量库的中文检索方案,部署门槛低;回答强制附带出处并设置拒答阈值,降低大模型胡编的风险;用模拟接口验证了大模型调用链路,并处理了 GBK 编码和缺少依赖等异常情况。

评论