立项原因:高校图书馆长期存在人工咨询人力不足、服务时间受限的痛点 —— 师生在开馆时间、借阅规则、座位预约、馆藏位置、文献精读等问题上高度依赖人工馆员,夜间、节假日及跨校区场景无人响应;同时馆藏资源分散在 ILS 系统与 PDF/Word/PPT 等多格式文档中,存在水印、页眉、目录噪音,传统关键词检索难以命中原文,业务规则库与馆藏文献库混杂还会导致跨校、跨库知识串扰,影响回答可信度。
行业场景:本项目面向高校智慧图书馆场景,覆盖入馆咨询、借阅 / 续借 / 预约规则问答、座位预约查询、自然语言找书、馆藏定位、文献摘要精读等核心业务,对接超星智慧图书馆已有业务系统(馆藏 ILS、业务规则库、电子图书库),服务对象为在校师生与图书馆馆员,已在多所高校图书馆试点落地,替代人工馆员提供 7×24 小时咨询服务。
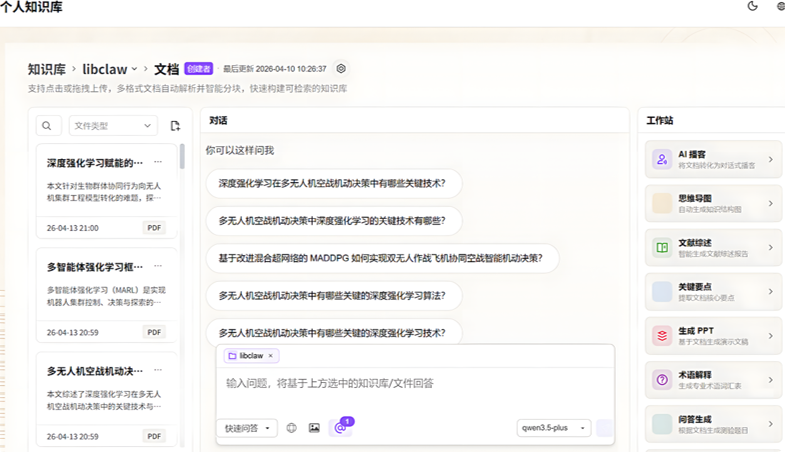
功能模块:项目由四大模块组成 ——①多源文档解析模块:对接超星智慧图书馆业务系统,采集开馆时间、借阅规则、座位须知、入馆教育材料,并用 PyPDF /python-docx/python-pptx 解析馆藏电子资源 PDF/Word/PPT/ 期刊章节,自动过滤水印、页眉、目录冗余内容,沉淀为私有知识库;②文本切片与向量化模块:按章节切分长文档、重叠窗口保留上下文,调用 Embedding 模型写入向量库,区分 "业务规则库" 与 "馆藏文献库" 两类知识库并分索引,避免跨库串扰;③智能体工具编排模块(核心):基于 LangChain 构建 ReAct 智能体,由大模型自主判断用户意图,自动路由到对应工具 —— 业务规则咨询走私有知识库 RAG 检索、自然语言找书走 ILS 馆藏接口返回位置与在馆状态、文献精读走原文检索生成摘要、通用闲聊走大模型原生回答且不触碰图书馆资源;④效果调优模块:基于多校试点反馈案例,调优召回 TopN、相似度阈值,增加元数据标签(学校名 / 文档类型)防止跨校知识串扰,并优化口语化提问的意图识别。
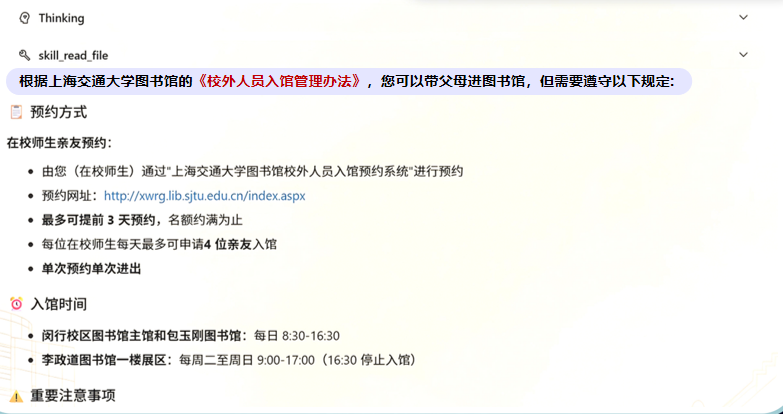
主要功能:为高校师生提供 7×24 小时 AI 馆员服务,一站式完成开馆 / 借阅 / 预约规则解答、自然语言查书定位、馆藏原文检索与文献摘要精读,全程强制 "无资料不编造",替代传统人工咨询窗口。
个人职责:本人作为 AI Agent 应用工程师,独立负责图书馆智能体从 0 到 1 的工程落地 —— 包括多源馆藏文档采集与解析脚本开发、私有知识库构建、文本切片与向量库搭建、基于 LangChain 的多工具智能体编排、系统提示词设计、以及多校试点后的效果调优与测试迭代全流程。
技术栈与架构:底层使用 Python 生态 ——PyPDF /python-docx/python-pptx 解析多格式文档;文本按章节切分 + 重叠窗口保留上下文;调用 Embedding 模型向量化后写入向量数据库;上层基于 LangChain ReAct 框架搭建智能体,由 LLM 自主完成意图识别与工具路由,统一调度私有知识库 RAG 检索、ILS 馆藏接口、文献精读三类工具。
实现亮点与难点:①多源文档治理 —— 自动过滤扫描件水印、页眉、目录冗余,解决 PDF/Word/PPT 混排导致的切片噪音;②知识库隔离 —— 业务规则与馆藏文献分索引构建,叠加学校名 / 文档类型元数据标签,防止 A 校用户查到 B 校制度;③意图路由精度 —— 通过系统提示词强约束 "无资料不编造、无馆藏不瞎答",并针对口语化提问(如 "这本书在馆吗")优化意图识别;④效果闭环 —— 基于试点 Bad Case 反向调优召回 TopN 与相似度阈值,持续提升检索准确率。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论