本项目面向金融与经济类企业的内部知识管理需求。企业内部沉淀了大量教材、规范与制度类文档(本次数据源为8册经济金融教材,合计187万字、1460个章节)。员工查询业务口径、术语定义时,只能靠人工翻阅纸质书或全文检索关键词,不仅效率低,且难以定位到具体出处,难以据此形成可追溯的合规结论。同时,直接接入通用大模型存在两方面问题:一是模型基于通用语料作答,对企业内部口径容易产生幻觉;二是若将内部文档送入公网API,将违反企业对数据不外传的要求。因此需要一套完全本地运行、结论可溯源的企业私有知识库问答系统。
统分为离线数据流、在线问答流与编排封装三层。
1)离线数据流:EPUB解析为结构化章节,规则清洗剔除书目与页眉噪声并合并短句,LLM辅助判定重复内容并输出冲突报告,表格图经OCR转为可检索数据表,按语义边界切片并向量化入库,最终形成4055条1024维向量。
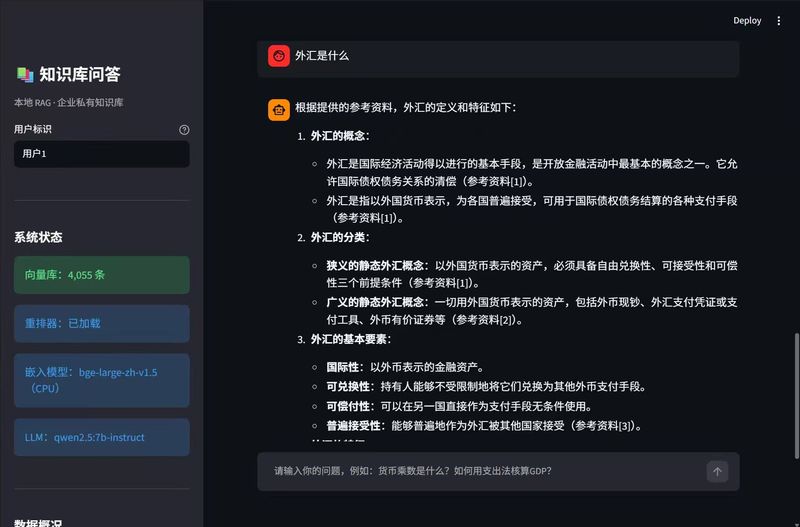
2)在线问答流:用户问题经查询改写后进行向量召回Top50,再由重排模型精排取Top5,通过置信度双阈值判定是否走知识库作答;高置信由本地大模型基于检索资料生成答案,低置信降级为通用模型作答并明确标注非知识库来源。
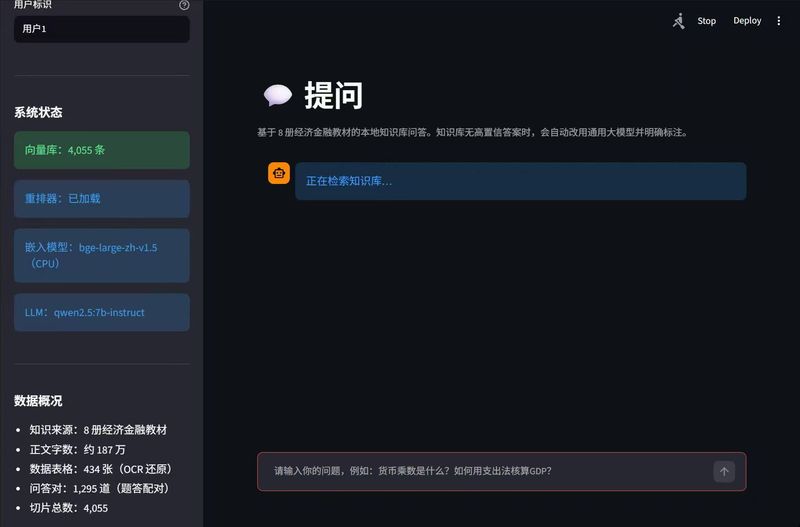
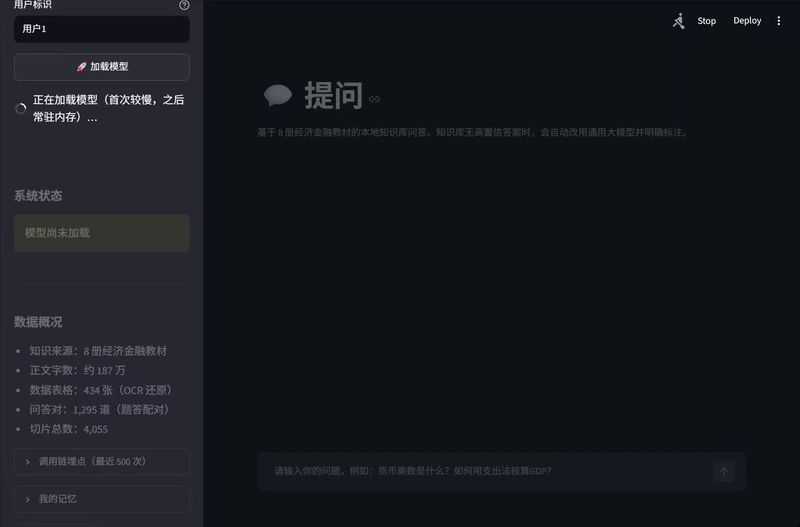
3)编排与封装:以LangGraph状态图串联全流程,FastAPI提供SSE流式接口,Streamlit实现对话与文档溯源界面,并提供全链路埋点、用户记忆与上下文压缩能力。
本人独立负责模块一至模块三的全部设计、实现与联调验收。技术栈:Python、FastAPI、LangGraph、Streamlit、Transformers、NumPy,模型侧使用bge-large-zh-v1.5(嵌入)、bge-reranker-large(重排)与Ollama+Qwen2.5-7B(生成)。实现亮点:一是经5个版本实测后放弃持久化不稳定的向量数据库,改用NumPy内存暴力余弦实现精确检索,单次召回0.001秒且无近似误差;二是置信度采用双阈值,分别对应重排分与余弦分,避免量纲混用;三是架构上将嵌入与重排固定在CPU、显存全部留给大模型,在单张8GB显卡上稳定以52 tokens每秒生成。主要难点:表格OCR按章节归属时曾出现相邻表共享同一张图、导致表号内容错位,通过改为整组表图绑定并合并OCR结果解决;大文件下载曾出现大小正确但内容损坏的静默失败,通过引入SHA256校验拦截,避免了模型加载后输出乱码的隐蔽故障。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论