在平台上运营着海量 SKU,商品从上架、成长、成熟到衰退、退市呈现出可量化的生命周期规
律。传统依赖人工经验的备货与淘汰决策存在三个痛点:
看不清:缺乏统一的生命周期阶段划分标准,无法快速回答"这个 SKU 处于什么阶段";
分不准:爆款、平销、昙花一现、长尾等不同形态的 SKU 混在一起管理,资源错配;
预判晚:滞销与缺货往往在发生后才被发现,缺少基于模型的提前预警。
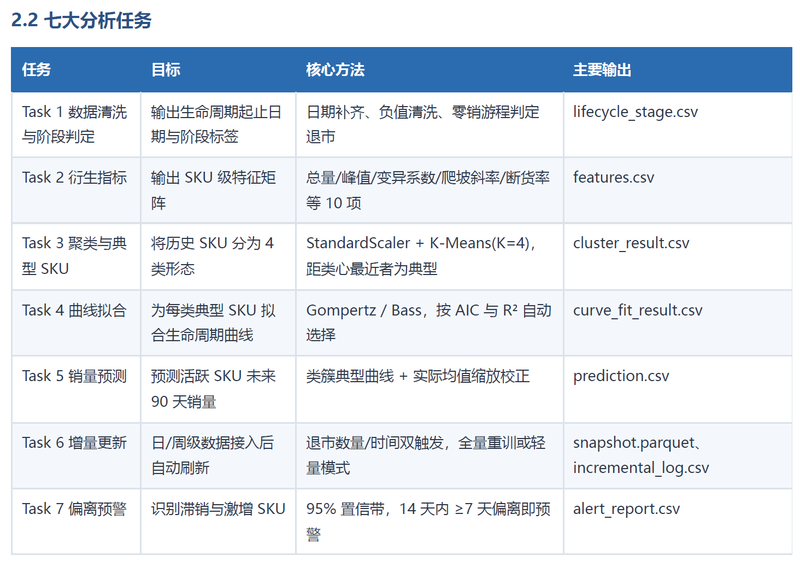
本项目以日度销量与库存数据为输入,构建了一套覆盖"清洗 → 特征 → 聚类 → 曲线拟合 → 预测 → 增量更
新 → 预警"的自动化量化分析系统,为备货、补货和淘汰决策提供数据支撑。
1.科学划分每个 SKU 的生命周期阶段(导入 / 成长 / 成熟 / 退市);
2.按生命周期形态对历史 SKU 聚类(爆款 / 平销 / 昙花 / 长尾),并识别每类典型 SKU;
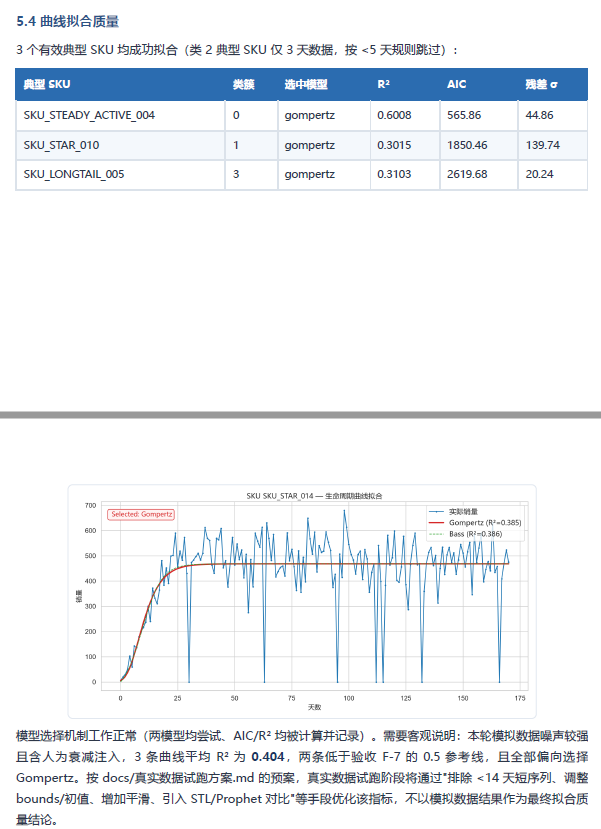
3.使用 Gompertz 与 Bass 两类经典增长曲线拟合典型 SKU,并按 AIC 自动选择最优模型;
4.基于"类簇典型曲线 + 均值缩放"为在售/新品 SKU 预测未来 90 天销量;
5.建立增量更新机制,按退市 SKU 数量与时间间隔自动决定全量重训或轻量刷新;
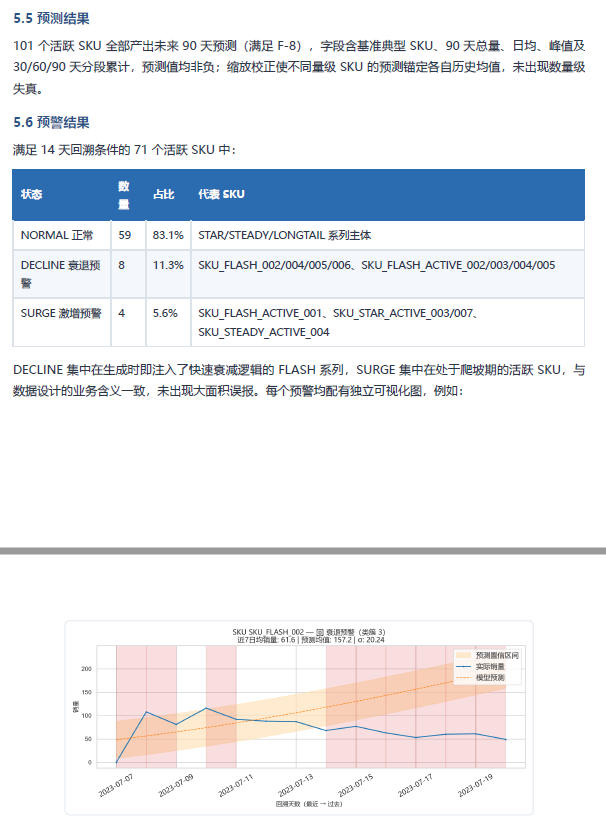
6.对活跃 SKU 进行置信区间偏离检测,输出衰退(DECLINE)与激增(SURGE)预警;
7.提供单 SKU 分析与多 SKU 对比两个交互式 Dashboard。
1. 流水线结构
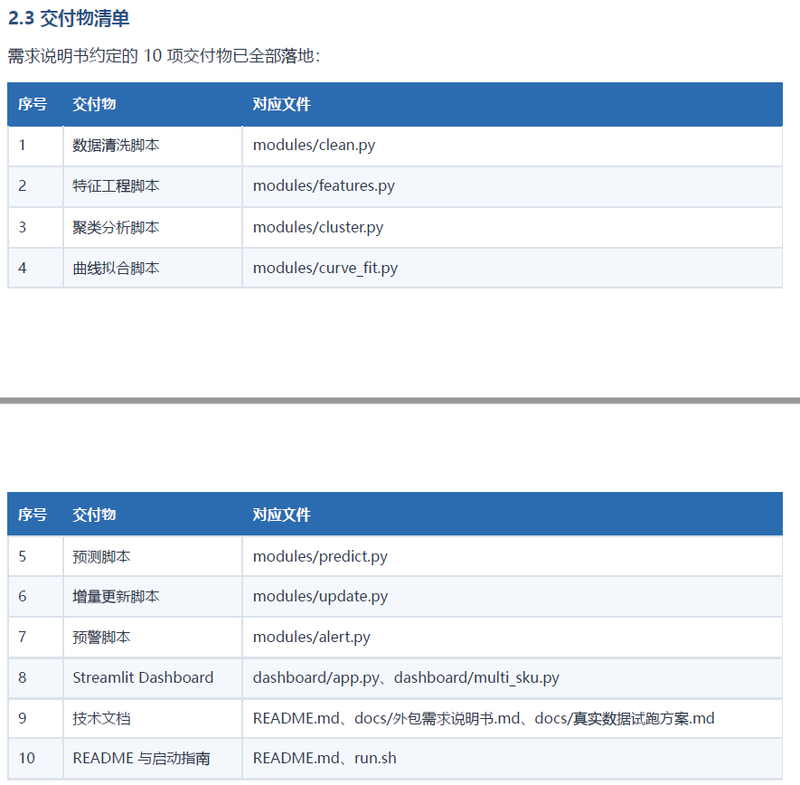
main.py 是单一入口,按固定顺序调用 modules/ 下的 7 个模块。模块之间不直接传复杂对象,而是通过`outputs/` 下的 CSV/Parquet/Pickle 文件解耦——每一步的产物落盘,下一步可从文件恢复,所以任何模块都能单独重跑调试。5 个绘图模块(`plot_*.py` )挂在对应分析步骤之后,只读产物不参与计算。
2. 三个核心算法点
- 退市判定 ( clean.py ):对零销序列做游程编号(streak id),求最长连续 0 销段 ≥ 14 天即退市;日期缺口用`date_range + reindex` 补齐,且只 reindex 数值列再 join 回 sku_id,规避了 pandas 2.x 分组键污染问题。
- 模型自动选择 ( curve_fit.py ):对每个典型 SKU 同时拟合 Gompertz 和 Bass 两条三参数曲线(带边界约束 + 峰值 1.2 倍的数据驱动初值,`maxfev=50000` ),按 AIC 更低 + R²>0.5 双门槛选优,残差 σ 留给预警模块复用。
- 新品预测 ( predict.py ):新品没有完整生命周期无法独立拟合,做法是 类簇典型曲线迁移 ——取同类典型 SKU 的模型生成 90 天基准曲线,再用`scale = 自身历史日均 / 典型SKU日均` 缩放锚定量级。这是整个系统把"历史形态"转化为"未来预测"的关键路径(图中高亮段)。
3. 增量更新机制
update.py 实现双触发: 新增退市 ≥50 个 或 距上次重训 ≥30 天 → 全量重训(重跑聚类/拟合/预测/预警);否则只复用旧参数轻量刷新预测。状态用 Parquet 快照 +`last_full_retrain.txt` 时间戳 +`incremental_log.cs
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论