语言技术
Python、React系统类型
Web行业分类
人工智能、企业服务开源地址
https://github.com/Sora130956/smart-data-extractor授权协议
GPL许可
1、立项原因 企业日常有大量非结构化资料,例如展会名片、发票、邮件和聊天里的销售线索、扫描件 PDF。这些资料靠人工逐条录入,耗时且容易出错。以展会名片为例,单场有 50–300 张,每张手录要 1–2 分钟,而展会后的有效跟进窗口只有 3–7 天,行业数据显示约 80% 的线索从未被跟进。直接用大模型提取虽然快,但会编造缺失字段、漏字段、给出虚高的置信度。OCR 错一位电话号码,这条线索就废了,而用户不知道哪里该复查。本项目要解决的产品问题是:提取要快,同时要让用户知道哪些结果可能错。做法是让错的被发现,漏的被标出,而不是静默猜测。
2、行业场景 业务背景是销售与 CRM 线索录入、展会名片批量入库、财务发票录入、扫描件 PDF 结构化归档。这些场景的文档类型各异,格式不固定,常常中英文混排。财务和销售数据对准确性要求高,错一位代价大,所以需要"自动提取 + 置信度分流 + 人工复核"的闭环,而不是单纯调一次大模型。
可在线体验:https://smart-data-extractor-vd19.onrender.com/
1、功能模块
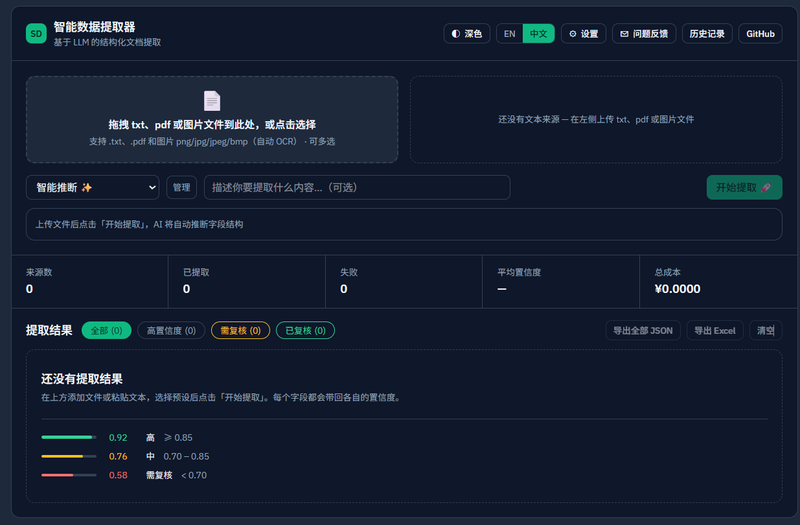
- 多源输入:粘贴文本、PDF(逐页处理)、图片(名片、发票等)。
- Schema 管理:内置联系人、发票、销售线索(BANT)三个预设,支持自定义字段,也可以让 AI 根据样例自动推断字段。
- 提取引擎:按 schema 做结构化提取,同时做格式校验和成本统计。
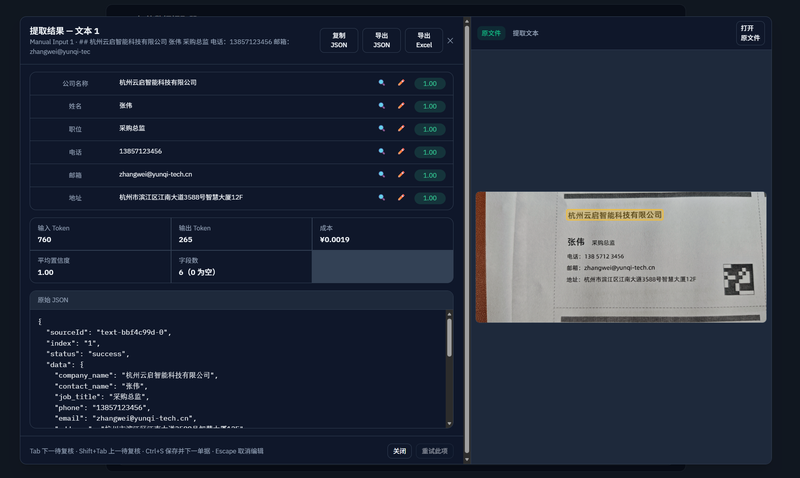
- 置信度与复核:每个字段带置信度,低置信或空值字段进入人工复核界面。
- 溯源:在原图上叠框,显示提取值出自原文哪个位置。
- 批量处理与导出:支持批量提取,导出 JSON 和 Excel。
- 其他:中英双语界面、历史记录、反馈邮件,以及 Web、REST API、CLI 三种使用方式。
2、主要功能描述 用户上传文件或粘贴文本,选择预设或自定义字段后,系统自动完成 OCR、结构化提取、格式校验和置信度计算。结果按每个字段设定的阈值(0.95、0.85、0.70、0.5 或允许为空)自动分流。高置信的结果直接通过,低置信的结果进入复核界面。复核时点击字段,原图会高亮对应位置。人工修改后会保留 AI 原值,方便追溯。复核完成后可导出表格。用户按 Ctrl+S 保存并跳到下一条待复核记录,复核效率较高。
1、我负责的任务 我独立完成了项目的全流程:需求分析与可行性验证、技术选型、验收标准制定、后端(FastAPI 接口、提取引擎、OCR 集成、限流重试、配额)、前端(React 复核界面、状态管理、Excel 导出、中英文国际化)、测试和 Render 部署。开发采用 TDD,决策记录在 ADR 中(D-001 至 D-049)。
2、技术栈与架构
- 后端:Python 3.11、FastAPI、Pydantic v2、pydantic-ai(调用 DeepSeek,temperature=0)、SQLAlchemy + SQLite、httpx、PyMuPDF。OCR 使用智谱 GLM-OCR。
- 前端:React 18、TypeScript、Vite、TanStack Query、Zustand、Zod、Tailwind、ExcelJS。
- 架构:依赖方向单向无环(config → validators → models → presets → extraction → api/cli)。前后端同源部署,后端直接托管前端构建产物。
3、亮点与难点
- 七层可靠性防线:覆盖输入、约束、校验、置信、溯源、复核、韧性。
- OCR 行级置信度融合:大模型只读文字,看不到图像是否模糊,自评容易虚高。我另外调用 OCR 的行级识别概率,取`min(模型自评, OCR 概率)` 。这样模糊或潦草的内容即使模型很自信也会被拉低,并进入复核。
- 运行时动态建模:按 schema 在运行时生成 Pydantic 模型,禁止多余字段,缺失必须返回 null,空值的置信度强制归零。
- 限流治理:第三方 OCR 有频率限制,信号量并发控制不够。我实现了自适应请求节奏(AIMD)、指数退避加抖动、前端自动重试,批量处理时单条失败不影响整批。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论