

面向定制 AI 芯片的深度学习框架适配项目:把 TensorFlow、PyTorch 训练与推理链路打通到定制硬件。负责编译器前端相关工作,包括阅读 TensorFlow XLA 源码、新增 HLO Pass 图优化(常量折叠、代数化简等)、自定义算子工程化路径对比与落地,并推进流水线并行方案调研;同时沉淀单测、调试、日志与打包规范,支撑大模型相关能力与疑难问题定位(拆图、数值不一致等)。


点击空白处退出提示



面向定制 AI 芯片的深度学习框架适配项目:把 TensorFlow、PyTorch 训练与推理链路打通到定制硬件。负责编译器前端相关工作,包括阅读 TensorFlow XLA 源码、新增 HLO Pass 图优化(常量折叠、代数化简等)、自定义算子工程化路径对比与落地,并推进流水线并行方案调研;同时沉淀单测、调试、日志与打包规范,支撑大模型相关能力与疑难问题定位(拆图、数值不一致等)。
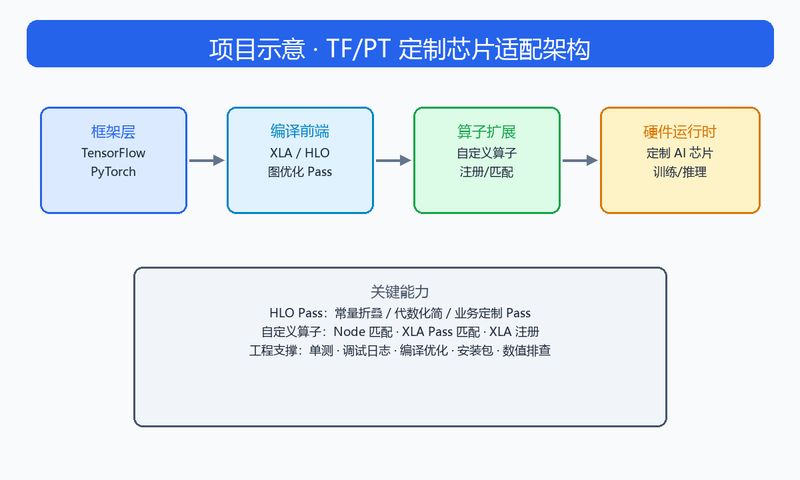
本项目面向定制 AI 芯片,完成 TensorFlow、PyTorch 框架适配,打通模型训练与推理在定制硬件上的工程链路。主要功能模块包括:(1)编译图优化模块:基于 TensorFlow XLA/HLO Pass 机制,落地常量折叠、代数化简等图优化,并支持新增适配业务的自定义 Pass;(2)自定义算子模块:支持 Node 节点匹配、XLA Pass 匹配、XLA 注册等多种算子接入路径,覆盖训练/推理常用算子扩展;(3)大模型支撑模块:推进训练与推理相关能力建设,调研并规划适合芯片的流水线并行实现;(4)工程验证与交付模块:提供 C++/Python 单元测试、调试与日志体系、编译优化与安装包制作,缩短从改动到验证的闭环时间;(5)问题诊断能力:针对拆图异常、数值对不齐等疑难问题提供定位手段。整体目标是让业务模型能在定制芯片上稳定、高效地完成训练与推理落地。
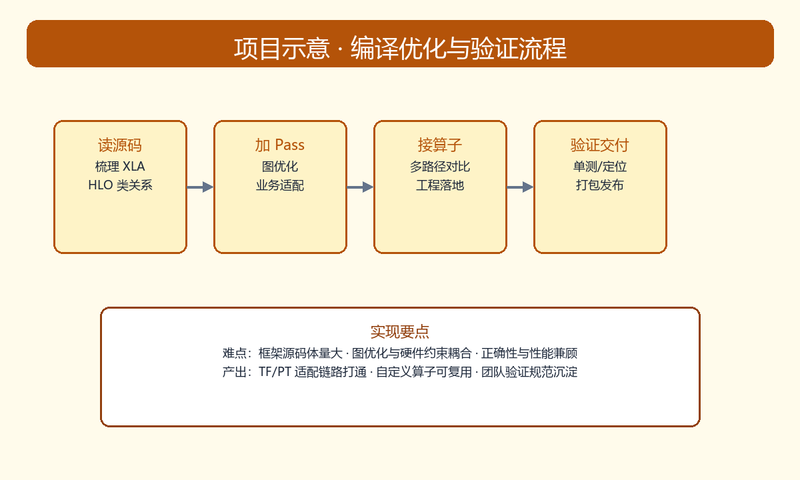
本人担任编译器前端工程师,核心负责框架适配中的前端编译与算子工程化。技术栈以 C++/Python 为主,深入阅读 TensorFlow XLA 与相关 PyTorch 源码,梳理 HLO Pass 类关系与执行机制,实现并验证适配业务需求的图优化 Pass。自定义算子方面,对比三种工程路径(Node 匹配 / XLA Pass 匹配 / XLA 注册)的优劣与适用场景,完成选型与落地。并行方向调研流水线并行原理、相关库优化点,制定适合定制芯片的实现方案。工程上沉淀单测、调试、日志、编译优化、安装包及Python 到 C++ 实现定位方法,提升团队效率;同时带教实习生完成基础功能,主导拆图原因、数值不一致等疑难问题定位。实现难点在于:框架源码体量大、图优化与硬件约束强耦合、算子正确性与性能需同时满足,以及大模型场景下并行策略与数值稳定性要求高。

评论