

当前大量国产算力芯片、消费级显卡以及边缘计算设备,其 64 位双精度(FP64)物理算力被严重降频甚至物理屏蔽。数据中心级别的满血 FP64 硬件(如 A100/H100)采购成本极高,中小企业与科研团队难以承担大规模高精度仿真集群的昂贵开销。在气象预测、流体力学(CFD)等海量数据累加场景中,原生 32 位精度极易发生“大数吃小数”导致的数值崩溃与仿真发散


点击空白处退出提示



当前大量国产算力芯片、消费级显卡以及边缘计算设备,其 64 位双精度(FP64)物理算力被严重降频甚至物理屏蔽。数据中心级别的满血 FP64 硬件(如 A100/H100)采购成本极高,中小企业与科研团队难以承担大规模高精度仿真集群的昂贵开销。在气象预测、流体力学(CFD)等海量数据累加场景中,原生 32 位精度极易发生“大数吃小数”导致的数值崩溃与仿真发散
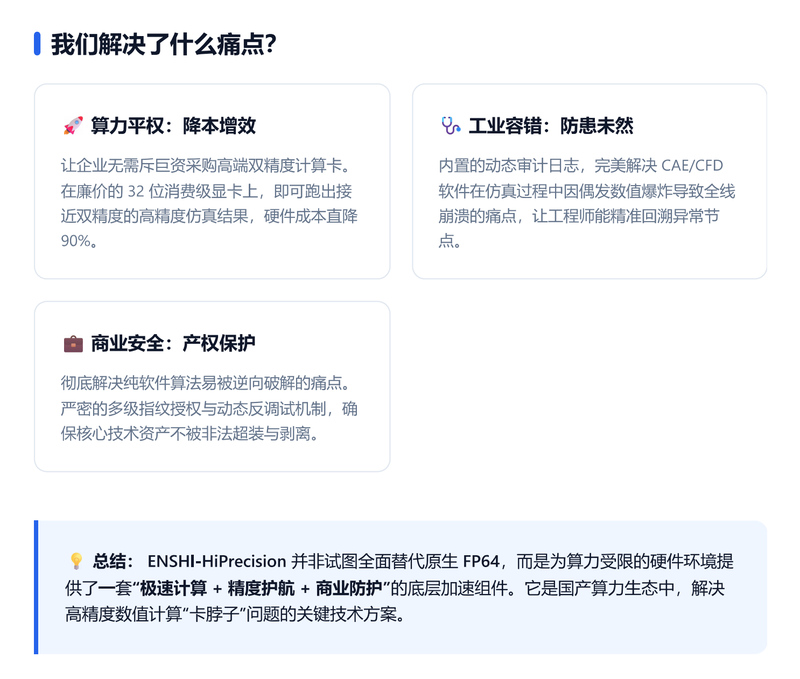
绕过传统高级语言的编译器优化限制,直接在 GPU 硬件指令层构建高密度的动态残差补偿机制,实现极低损耗的算力压榨。采用冷热路径分离技术,核心计算库全面进行符号剥离与内存混淆,实现“计算零延迟、核心零泄漏”的防逆向保护。
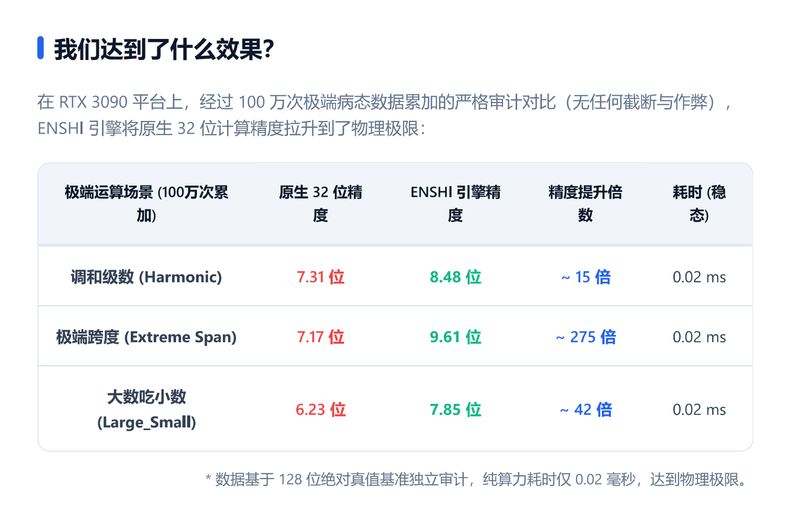
在 RTX 3090 平台上,经过 100 万次极端病态数据累加的严格审计对比(无任何截断与作弊),ENSHI 引擎将原生 32 位计算精度拉升到了物理极限:

评论