

面向稀疏奖励环境下的智能体决策优化。智能体在大多数时间步得不到有效反馈,只有完成目标时才获得奖励,容易出现探索效率低、训练周期长、样本价值差异大和策略收敛不稳定等问题。本项目借鉴海马体经验回放机制,按照新近度和价值密度组织经验,并在训练前筛选高价值样本,减少无效数据对策略更新的干扰。该方法可用于机器人导航、仿真训练、自动驾驶决策和其他需要提升样本效率的强化学习场景。


点击空白处退出提示



面向稀疏奖励环境下的智能体决策优化。智能体在大多数时间步得不到有效反馈,只有完成目标时才获得奖励,容易出现探索效率低、训练周期长、样本价值差异大和策略收敛不稳定等问题。本项目借鉴海马体经验回放机制,按照新近度和价值密度组织经验,并在训练前筛选高价值样本,减少无效数据对策略更新的干扰。该方法可用于机器人导航、仿真训练、自动驾驶决策和其他需要提升样本效率的强化学习场景。
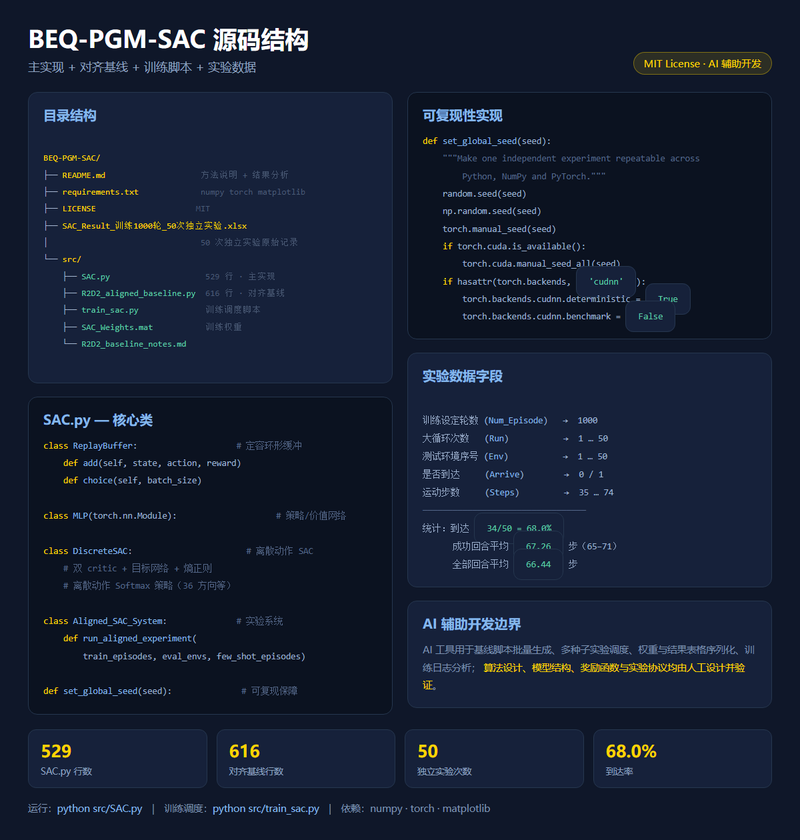
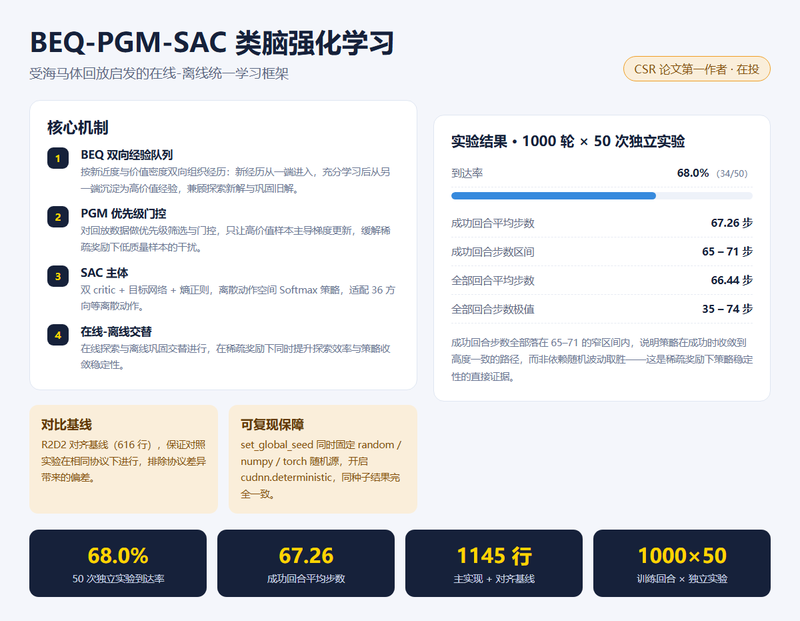
本项目实现了一套面向稀疏奖励任务的强化学习算法与实验系统。BEQ双向经验队列分别保留近期探索经验和高价值成熟经验,使智能体兼顾探索与利用;PGM优先级门控在梯度更新前评估并筛选训练样本;主体采用离散动作Soft Actor-Critic,包含双Critic、目标网络和熵正则,可适配三十六方向等离散动作空间。系统同时提供对齐的R2D2基线、多环境评估、少样本泛化测试、统一随机种子和原始实验数据。
本人独立负责算法设计、核心代码、实验协议和全部实验执行。完成BEQ双向队列、PGM门控、离散动作SAC及R2D2基线实现,并统一训练轮数、评估环境和统计口径。项目共约1145行,使用Python、PyTorch、NumPy和Matplotlib;完成50次独立实验,统计到达率为68.0%,成功回合平均步数为67.26。相关论文以第一作者投稿至《Cognitive Systems Research》,目前在投。

评论