测序数据落到服务器之后,真正的压力才开始:一个测序场景往往包含几十到上百个文件,算法分两类——文件级算法(每个文件独立处理)和场景级算法(必须等整个场景的文件全部齐备才能计算)。传统做法是等数据全部到齐再统一跑,结果是仪器还在采集时服务器完全空转,整条出结果的链路被拉长几个小时甚至更久。另外不同测序场景调用的算法模块与生信模块组合并不相同,如果把流程硬编码在代码里,每新增一种场景都要改代码、发版本,维护成本极高。
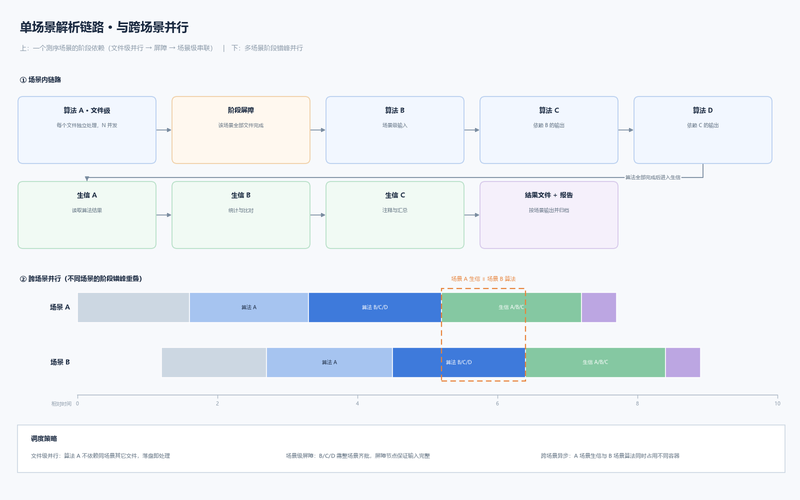
本系统把"数据到达 → 解析 → 出报告"做成可编排的流水线:上传软件每传完一个文件就发 MQTT 通知,服务器即时入队并开始文件级解析,做到采集、上传、解析三段重叠;整个场景齐批后由屏障节点自动释放下游场景级算法与生信模块;所有模块以 Docker 容器方式调用,依赖与版本相互隔离;同时支持多个场景的阶段错峰并行,把设备利用率和服务器吞吐同时拉到上限。
系统包含七个部分:
1)事件接入与幂等:订阅 MQTT 文件级完成通知,以 file_id 去重,重复通知不重复建任务。
2)场景模板:每个测序场景绑定一条链路定义(算法 A/B/C/D 与生信 A/B/C 的组合关系),新增场景只加模板,不改调度代码。
3)任务队列:文件级任务与阶段级任务分队列管理,按优先级与资源水位调度。
4)阶段屏障:同一场景的全部文件级任务成功且校验通过后,批量释放下游场景级模块,避免"边算边等"的竞态。
5)容器执行器:每个模块通过 docker run 调用独立容器,统一处理镜像版本、目录挂载、退出码判断与日志采集,并设置并发上限、超时与失败重试策略。
6)跨场景并行:不同场景的不同阶段可同时运行(例如场景 A 的生信任务与场景 B 的算法任务并行),互不阻塞。
7)结果与状态:按场景输出结果文件与报告,任务与阶段状态持久化,可追溯、可从断点恢复。
技术栈:Python + MQTT + Docker(容器化模块调用)+ 任务队列 + 状态持久化。整体为常驻后台服务。
四个关键设计与难点:
① 文件级与场景级混合依赖的建模。这两类任务的依赖语义完全不同:前者"来一个算一个",后者"必须等齐"。如果把等待逻辑写成轮询计数,很容易出现重复触发或漏触发。最终用显式的屏障节点建模:文件级任务全部成功后,屏障置为就绪,一次性释放下游,天然避免竞态。
② 容器调用的可控性。模块全部以 docker run 调用,就必须把镜像版本、输入输出挂载目录、退出码判读、标准输出与日志采集统一封装,否则不同模块各写一套,出问题无法定位。同时设定超时强制回收与失败退避重试,避免僵尸容器占资源。
③ 吞吐与资源隔离。并发上限按场景与模块两级控制,防止单个大场景吃满整机导致其它场景排队;容器隔离保证算法与生信模块的依赖版本互不干扰,升级单个模块不影响其它链路。
④ 幂等与可恢复。任务状态持久化,服务重启后按状态重建队列:已完成的阶段不重跑,未完成的从断点继续,保证重放安全。
交付结果:采集、上传、解析三段重叠,整体出结果时间显著缩短;整场景齐批后下游自动触发,全流程无需人工干预;新增测序场景只需配置模板,不再改动调度代码。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态








评论