1、立项原因:公司业务数据分散在新老业务系统、CRM、多地 OA、营销投放等多个系统里,各部门报表依赖零散的同步脚本和旧报表系统,口径不统一、出数慢;同步、调度、实时链路和报表又分属不同工具,作业一多就说不清哪些在跑、哪些失败、改一张表会影响哪些报表。立项目标是用一个平台把「接数据 → 加工 → 调度 → 治理 → 看板」串成一条线,让很小的数据团队也能稳定支撑全公司的数据需求。
2、行业场景:高端消费品回收行业(黄金首饰、名表、箱包、数码等),线上投放获客(信息流、内容平台、直播、搜索竞价),线下门店鉴定成交。网络部、客服、营销、运营、财务等部门每天要按门店、渠道、品类、人员查看预约、到店、成交、毛利等指标,部分场景要求准实时。平台已在公司生产环境稳定运行,同时打磨成可私有化部署的产品,面向数据分散、没有专职大数据团队、要求数据不出门的中小企业。
平台按「接数据、加工、治理、用数据、管平台」组织,主要模块:
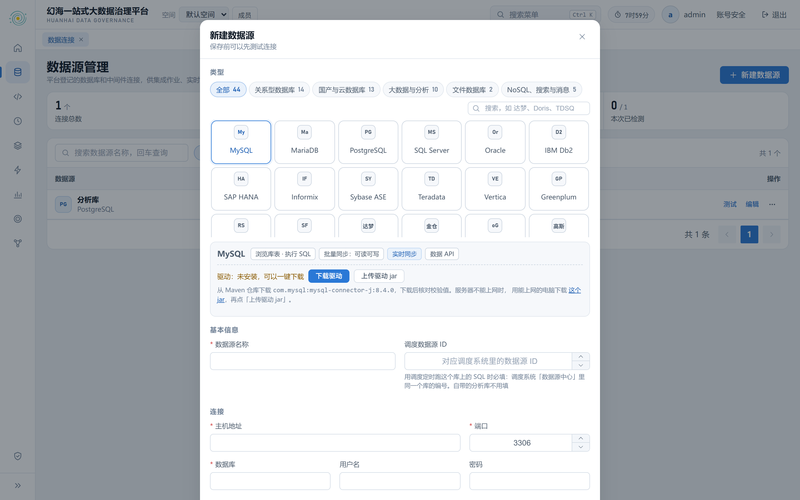
1、数据集成:数据源管理支持 MySQL、PostgreSQL、SQL Server、Oracle、达梦等 44 种数据库,驱动一键下载并校验;批量同步基于 DataX(整表/增量、自动建表并带注释、失败重试、同步后自动对账);实时同步基于 Flink CDC,按整库实例配置、可断点续传;SeaTunnel 可按作业选作第二引擎;支持 Excel/CSV 文件导入。
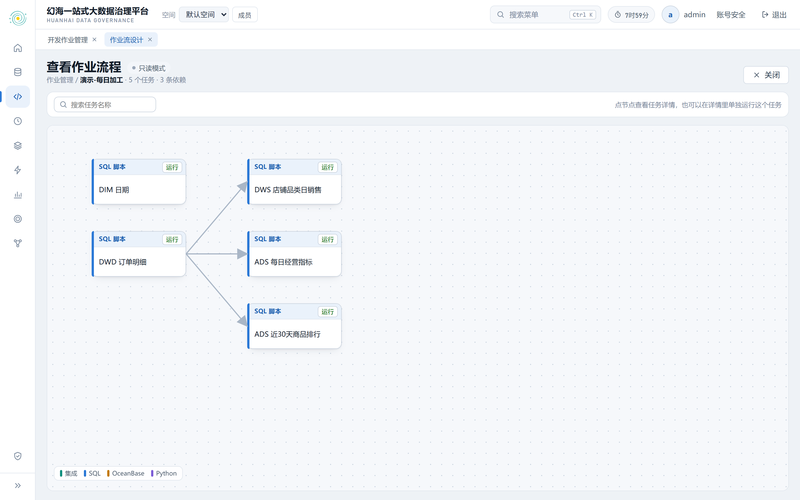
2、开发调度:在线 SQL/Python 脚本开发,试运行只读执行,带版本管理与回滚;拖拽式作业流编排,对接 DolphinScheduler 实现定时调度、上游依赖、失败重试和超时告警;作业监控可查每次运行的日志。
3、数仓建模:ODS/DWD/DWS/ADS 分层管理,支持关系建模与维度建模,自动生成 DDL/SQL。
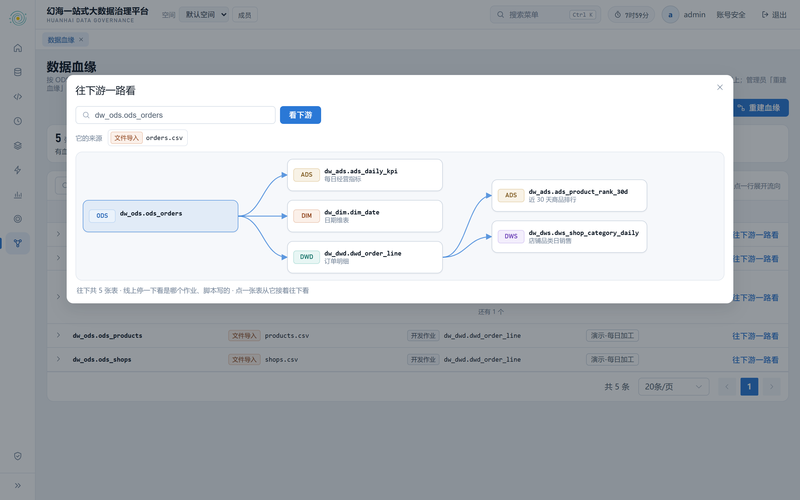
4、数据治理:数据质量规则、数据字典、自动解析的数据血缘(任选一张表可一路追到下游报表)、指标口径登记、报表发布前与源系统对账验收。
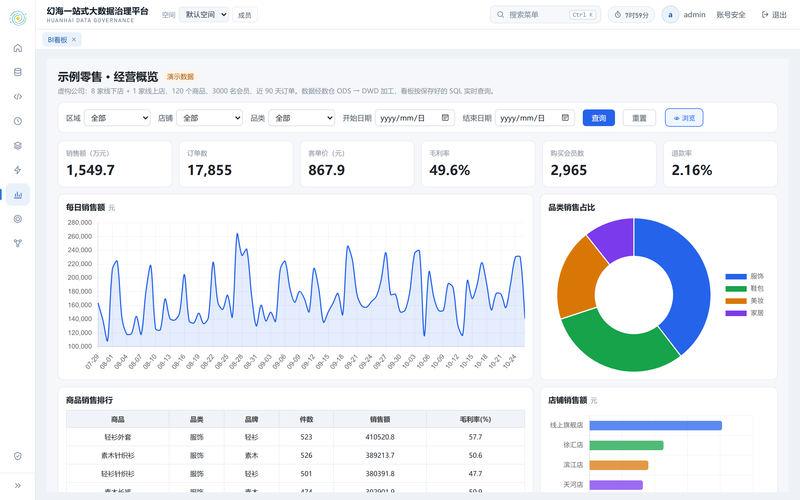
5、数据应用:配置化 BI 看板(数据集 + 组件取数,按部门分组,行级数据权限);HTML 报表导入后逐个组件绑定 SQL;数据表一键发布为数据接口(密钥、限流、调用审计);可选 AI 问数。
6、平台管理:角色、项目空间、数据源三层权限,三员分立,LDAP/钉钉/企业微信/飞书登录与双因素认证,操作审计,系统健康自检与群机器人告警;Docker 单机部署,一条命令完成安装、升级、备份和恢复。
1、我的职责:担任平台架构师兼核心开发,从 0 到 1 负责需求分析、架构设计与技术选型、前后端核心开发、生产部署与运维,并负责公司数仓分层建模和各部门报表交付。引入 AI 编码工具提升交付效率,本人负责架构决策、技术选型、问题定位与测试验收。
2、技术栈与架构:Spring Boot 3.5(Java 17)+ Vue 3 + Element Plus + Vite;PostgreSQL 同时作平台库和数仓;DataX、Flink CDC、SeaTunnel 三类同步引擎,SQL Server 实时链路对接 CloudCanal;DolphinScheduler 调度;组件全部 Docker 化,单机即可部署。
3、亮点与难点:
① 同步不丢数:任一行写不进去即判失败,日志直接指出哪一列、什么原因;整表覆盖写 PostgreSQL 可先写临时表、成功后一次替换,中途失败目标表原样不动。
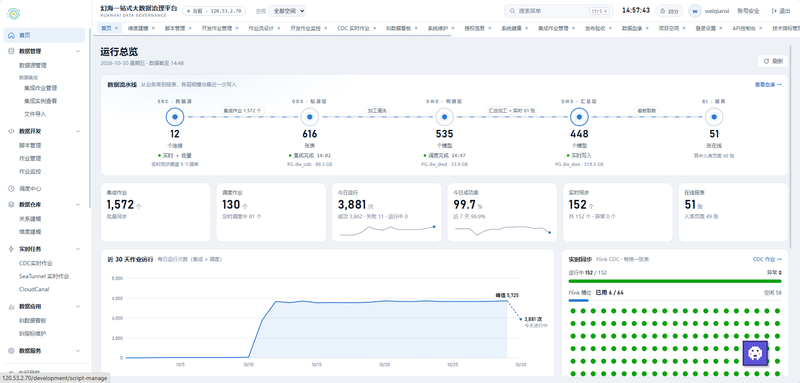
② 实时链路整合:原来每张表一个 Flink CDC 作业(48 个),改为按库实例合并成 5 个整库作业,目前覆盖 150 多张表,可从断点续传。
③ 调度状态一致:平台作业与 DolphinScheduler 实例双向绑定、状态回传,解决失败重跑、停止后状态反转、孤儿实例等问题。
④ 生产运维:平台整体迁移到新服务器;用 pg_upgrade 完成 PostgreSQL 15→18 大版本升级,停机 39 分钟;经大页内存、WAL 和后台写进程调优,强制检查点占比从 52% 降到 6%。
⑤ 生产规模:接入 12 个数据源、1,500 多个同步作业,日均运行约 5,300 次、成功率 99.99%;数仓约 1,700 张表、9 亿多行;51 个 BI 看板。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论