

香港1823、TMO、RCC三渠道山坡维修申请量巨大,人工登记、分派与回复起草耗时且易错,亟需自动化处理。
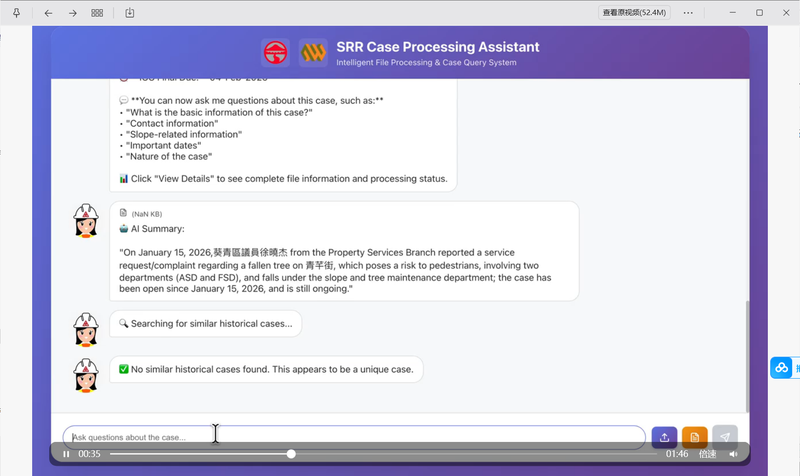
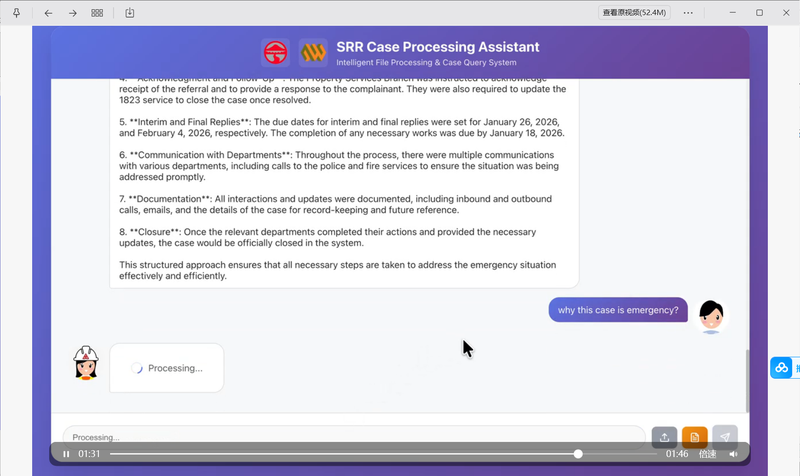
项目是一个面向香港政府的 Agentic AI 案件处理系统,自动完成山坡维修申请(SRR)的全流程处理:多格式文档解析、18个字段智能提取、相似案件检索、部门路由、质量评估与双语回复起草,将原本人工数小时的处理流程压缩到分钟级。


点击空白处退出提示



香港1823、TMO、RCC三渠道山坡维修申请量巨大,人工登记、分派与回复起草耗时且易错,亟需自动化处理。
项目是一个面向香港政府的 Agentic AI 案件处理系统,自动完成山坡维修申请(SRR)的全流程处理:多格式文档解析、18个字段智能提取、相似案件检索、部门路由、质量评估与双语回复起草,将原本人工数小时的处理流程压缩到分钟级。
1. **输入适配模块**:接收 TXT 邮件、PDF/DOCX 表单、扫描件与图片,支持 ZIP 递归解压与文件类型识别;
2. **字段提取模块**:LLM 按 Schema 做 18 字段 A→Q 提取,Regex 兜底强格式字段,fill_missing 机制跨附件补全;
3. **检索与路由模块**:pgvector + BM25 混合检索匹配相似案件(地理50%/山坡30%/来电者20%加权),SMRIS 责任查询 + GeoInfo 地址校验实现部门智能路由;
4. **质量评估模块**:关键词过滤 → 规则校验 → RAGAS LLM 评判的三级漏斗;
5. **自我修复模块**:Best-of-N 对比 + 四类故障差异化回退(覆盖率不足转 BM25、提取不完整转 LLM Vision 等);
6. **回复生成模块**:案件 Summary 生成 + 按政府 Reply Slip V02 格式起草中英双语回复;
7. **前端交互模块**:React 聊天机器人,SSE 流式输出、多文件批量上传、对话历史管理。
本人独立主导系统架构与全栈交付:**
- 设计 7 层 Agentic 架构与 PostgreSQL + pgvector 数据库,实现三层记忆系统(TaskState / SessionState / Domain 修正反馈);
- 构建多格式文档解析流水线(PyMuPDF / OCR / 视觉分析)与 Schema 驱动字段提取;
- 实现混合检索、加权重排与部门路由;开发三级质量评估与自我修复机制;
- 开发 React 前端与 SSE 流式接口;Docker 全栈容器化部署;
- 迭代 Prompt Engineering 将文档处理准确率从 82% 提升至 95%,优化 Token 缓存使 API 成本降低 25%。
**技术栈**:Python、FastAPI、React、PostgreSQL、pgvector、ChromaDB、LangChain(ReAct)、RAGAS、OCR / LLM Vision、Docker、Azure、GPT-4 / Claude。
## 四、架构与实验亮点、难点
亮点:
1. **检索层创新**:向量语义检索与 BM25 关键词检索融合,按业务字段加权(地理位置50%),兼顾"意思相近"与"编号精确"两类匹配需求;
2. **质量闭环**:评估漏斗 + 自我修复 + 用户修正回流的 Domain 记忆,形成"处理→评估→学习"的持续优化循环,这是系统从 demo 走向生产可用的关键。
难点:
1. **扫描件噪声大**:OCR 错误导致 LLM 字段提取不稳定——用三级评估先检出质量问题,再触发差异化回退策略解决;
2. **字段跨文件分布**:来电者信息、地址、图则往往分散在多个附件——设计 fill_missing 多文件补全与回溯机制;
3. **政府格式强合规**:回复必须符合 Reply Sli

评论