情感陪伴类 AI(虚拟伴侣、AI 角色扮演、情感树洞、心理自助陪伴)的用户价值不来自单轮回答质量,
而来自"关系连续性"——它要记得三个月前你说过的话、记得关系的转折点、记得你自己都忘了的细节。
但整个行业卡在同一个工程瓶颈上:主流大模型上下文窗口有限,而陪伴型对话单次会话动辄数千楼、
数百万 token。一旦超出窗口,早期记忆被整体丢弃,AI 立刻"失忆",用户投入的情感沉没成本瞬间归零。
这是陪伴类产品留存断崖的首要原因,也是"聊得越久越难聊"的根因。
现有三类解法都不理想:一是向量库 RAG,把记忆压成不可读的向量,用户看不见、改不了,记错了
只能重开角色;二是让模型自己总结,成本高、不可控、易编造,摘要越滚越失真;三是简单截断,
直接牺牲长期记忆。
我们的立项判断是:陪伴产品的记忆不该是黑盒检索器,而应是一份用户可拥有、可编辑、可回溯的
"关系档案"。因此本项目构建了一套面向长程情感对话的记忆与上下文编排运行时,把"记住"拆解成
可验证的工程问题:抽取什么、保留什么、何时压缩、压完还能否找回、用户能否干预。
产品面向虚拟伴侣、AI 角色扮演、情感陪伴社区等场景,同时可作为通用大模型应用的长期记忆中间件复用。
产品由「陪伴端」与「记忆引擎」两层、七个模块构成。
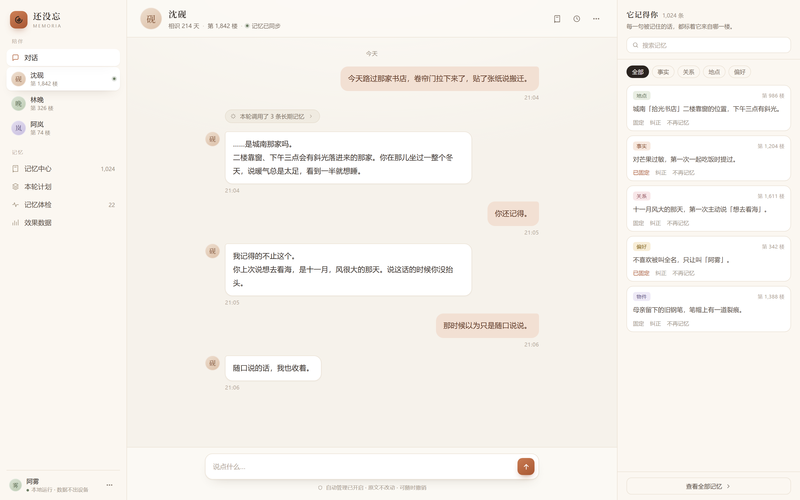
① 陪伴会话:装上即用,无需配置。前 20 轮为静默观察期,只在后台记录、不改动任何发送内容;
之后自动注入相关旧记忆,上下文接近上限时自动压缩,用户全程无感。引擎异常时一律原样发送,
不影响正常聊天。
② 记忆抽取与生命周期:后台从对话中抽取事实、人物/地点/物品/关系、章节摘要、待办与时间线,
经 candidate→observed→confirmed→active 五态流转;低置信度与冲突内容停在候选,不覆盖已确认事实。
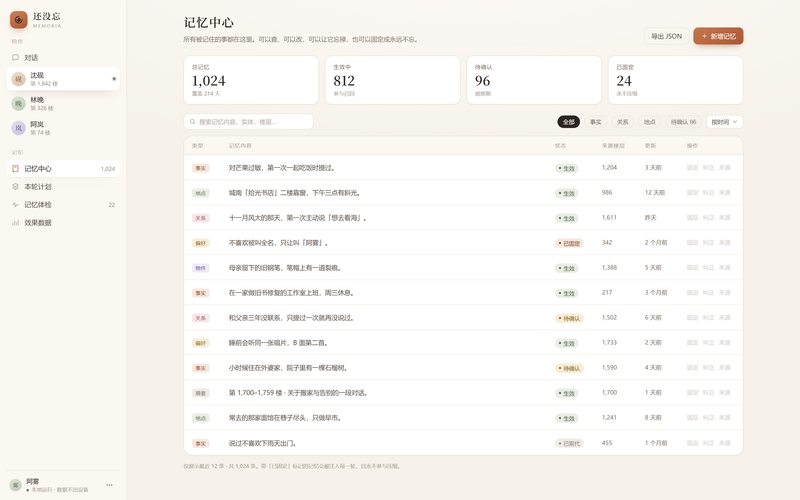
③ 记忆中心:按关键词、类型、时间、楼层区间、说话人检索全部记忆。每条可「固定为锚点」
「纠正」「不再记忆(持久阻断)」「查看来源楼层」,把记忆变成用户可编辑、可管理的资产。
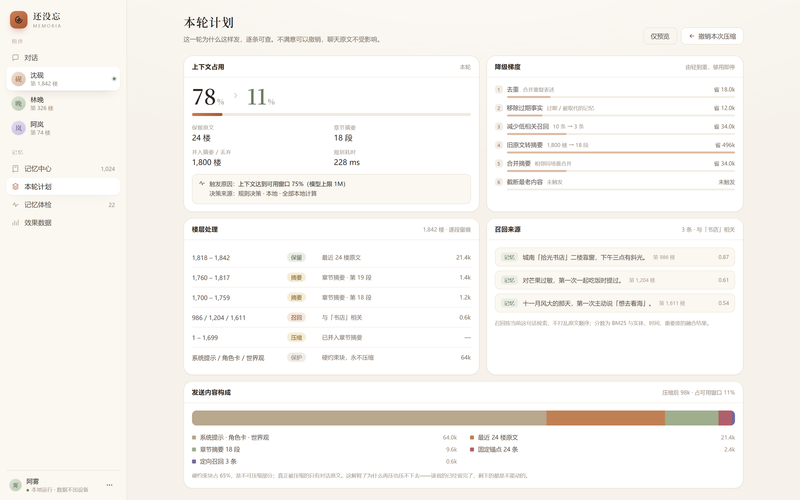
④ 本轮计划(可解释):逐条展示本轮为什么保留、为什么压缩、召回了哪些旧记忆、丢弃了哪些楼层
及原因,可一键撤销本次压缩,也可回到任意历史快照。
⑤ 预算感知压缩:按"去重→移除过期事实→减少低相关召回→旧原文转抽取式摘要→合并摘要→截断"
六阶梯度降级。系统提示、角色卡、世界观设定、用户最新输入永不压缩;确实无法满足预算时阻止发送
并给出修复动作,绝不静默截断。
⑥ 定向召回:自建中文倒排索引与 BM25,融合实体、时间、重要度打分,按当前这句话检索旧线索并注入。
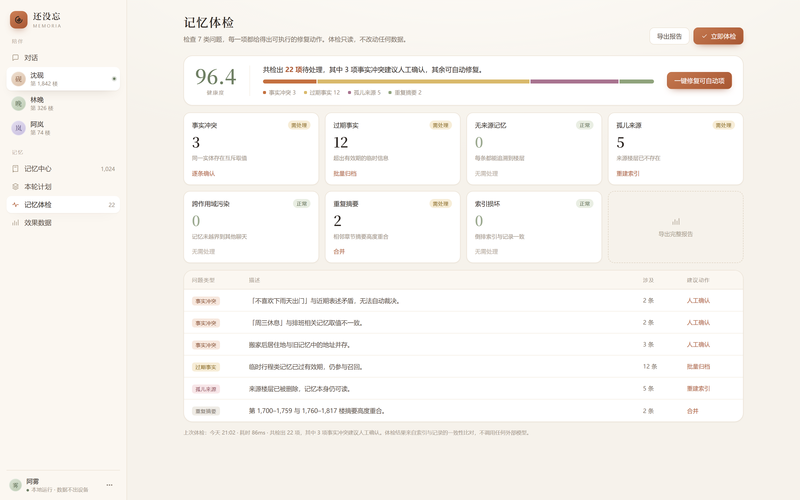
⑦ 可信与运维:压缩前自动快照、一键恢复;记忆体检自动检出冲突、过期、孤儿来源、跨作用域污染;
支持从五类旧工具迁移并可回滚;诊断页提供服务状态、压缩账本、任务队列与环境探针。
【我负责】独立完成全流程:需求定义与竞品调研 → 架构设计 → 抽取/召回/压缩三类核心算法 →
前后端全部实现 → 测试与实验评估 → 打包发布。无外部协作方。
【技术栈】JavaScript(ESM) + Node.js(零第三方依赖,仅内置模块)+ SQLite(node:sqlite, WAL)
+ 自建中文分词与 BM25 倒排 + SSE 实时推送 + 原生 HTML/CSS。可选接入决策模型做意图判定。
【架构】三层解耦:
· 接入层——浏览器适配器:事件监听、发送前拦截、用宿主 tokenizer 做最终 token 复核;
· 引擎层——身份作用域、事件流、记忆生命周期、实体图、抽取器、抽取式摘要器、检索、预算、
规划器、快照、任务队列、健康检查共十余个纯函数模块;
· 存储层——SQLite 权威存储 + journal 降级,上层统一投影,摘要/索引/统计均可从事件流重建。
同一内核支持两种部署形态(进程内插件 / 独立本地服务),宿主差异只隔离在一个适配文件的两点:
谁鉴权、服务实例怎么取,核心模块完全复用。
【亮点】
1. 提取式压缩而非生成式摘要:不改写原文、逐句可溯源、记忆维护零大模型成本。
2. 摘要打分引入词汇稀有度(IDF)与新颖度,解决"模板句挤占伏笔句"的真实缺陷,
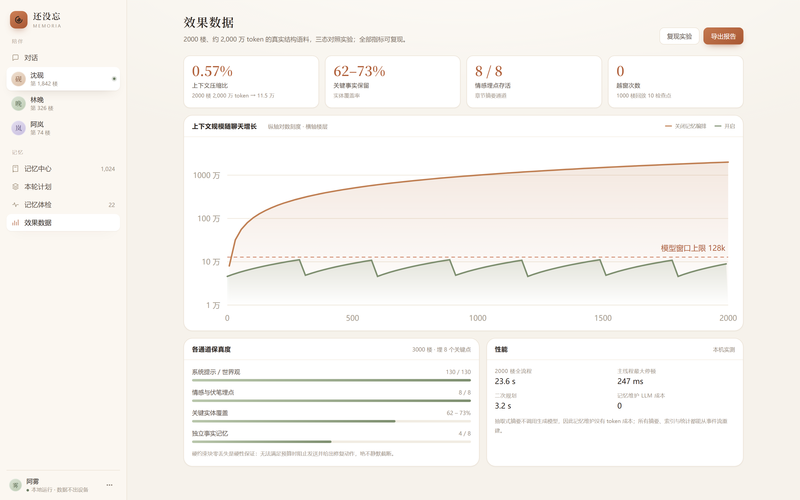
关键埋点存活率 3/8 → 8/8。
3. 全链路可回滚:每次压缩前自动快照,任何一步都能撤销。
4. 性能:2000 楼全流程 23.6s 后台分摊,主线程最大停顿 247ms;摘要多样性计算从平方级
收敛到有界候选池。
5. 26 个测试文件、190+ 用例,含仓库布局守卫测试;三态对照实验数据可复现。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论