

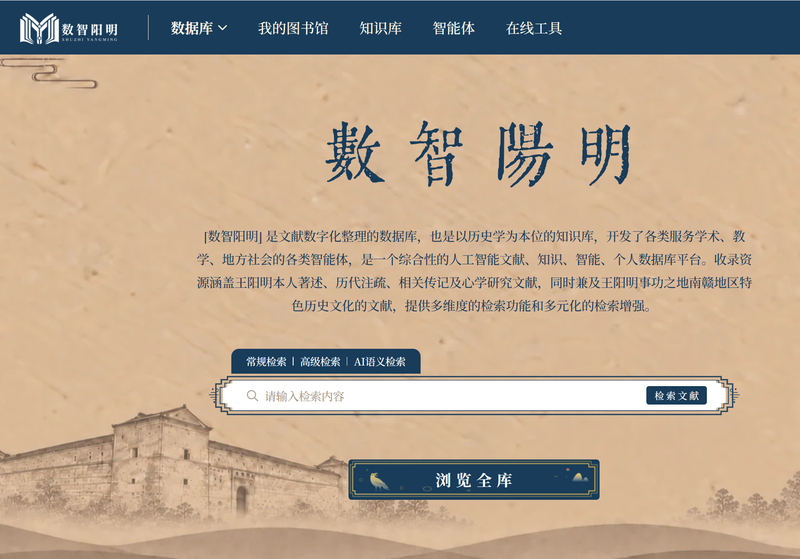
是文献数字化整理的数据库,也是以历史学为本位的知识库,开发了各类服务学术、教学、地方社会的各类智能体,是一个综合性的人工智能文献、知识、智能、个人数据库平台。收录资源涵盖王阳明本人著述、历代注疏、相关传记及心学研究文献,同时兼及王阳明事功之地南赣地区特色历史文化的文献,提供多维度的检索功能和多元化的检索增强


点击空白处退出提示



是文献数字化整理的数据库,也是以历史学为本位的知识库,开发了各类服务学术、教学、地方社会的各类智能体,是一个综合性的人工智能文献、知识、智能、个人数据库平台。收录资源涵盖王阳明本人著述、历代注疏、相关传记及心学研究文献,同时兼及王阳明事功之地南赣地区特色历史文化的文献,提供多维度的检索功能和多元化的检索增强
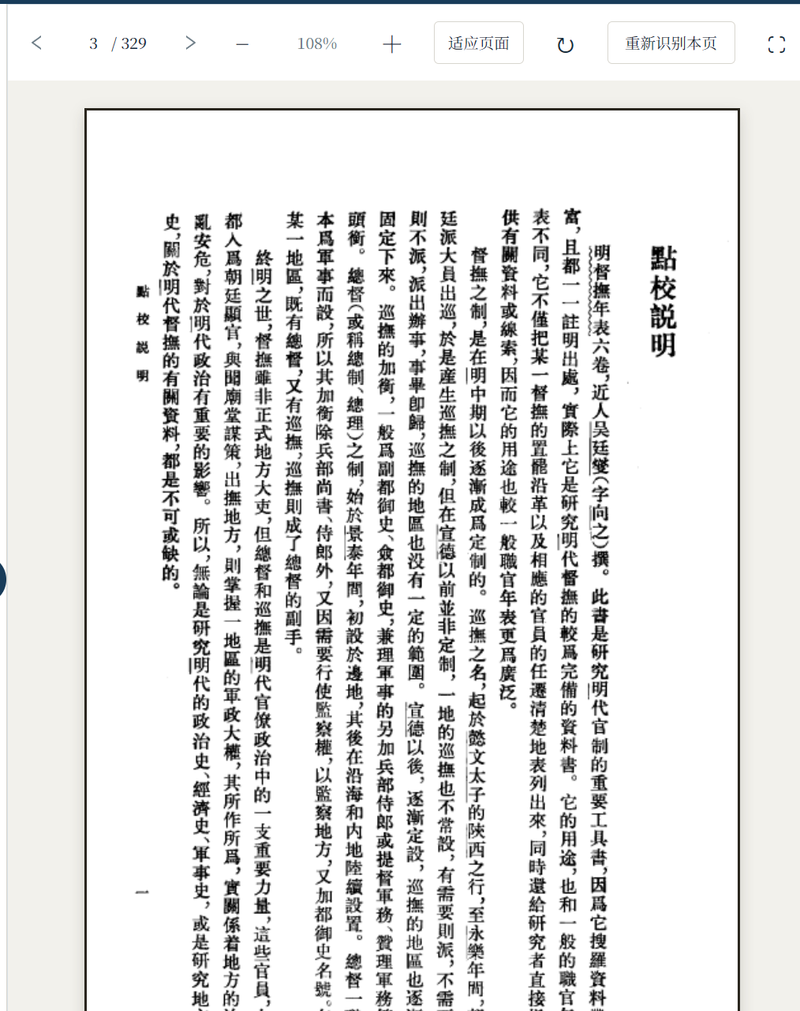
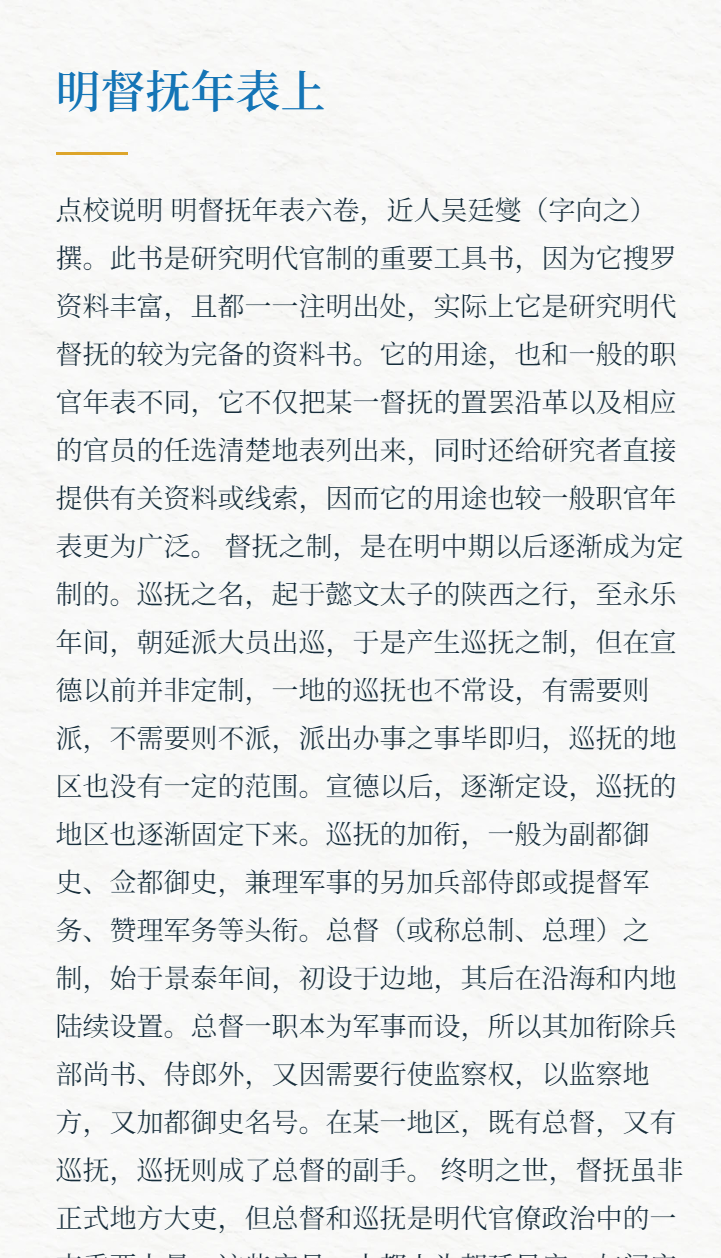
1古籍智能数字化(OCR识别):平台内置针对古籍文献优化的高精度OCR识别引擎,专门解决繁体字、竖排排版、异体字及无标点古籍的识别难题。用户可上传古籍图像,快速将其转化为可检索、可编辑的数字文本,大幅降低古籍整理与阅读的门槛。
2多维度智能检索系统:提供“常规检索”、“高级检索”与“AI语义检索”三位一体的搜索模式。不仅能实现精准的关键词匹配,还能通过AI深层语义理解,跨越字面限制,精准定位海量文献中的关联知识与目标内容。
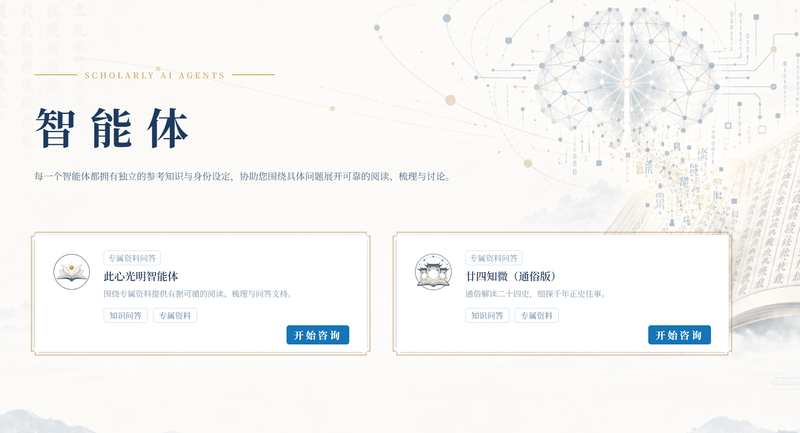
3AI智能体与知识库:针对学术研究、高校教学等场景开发了各类垂直领域AI智能体。通过构建知识图谱,提供文献自动摘要、深层知识关联与智能问答服务,深度辅助学术科研。
4综合性文献与个人图书馆:全面收录王阳明著述、历代注疏及南赣地区特色文化文献。同时提供完善的在线工具,支持用户建立专属的个人图书馆,实现文献的收藏、批注与个性化管理。
1、“我”负责哪些具体任务?
我主要负责古籍文献OCR识别模块、知识库数据处理以及智能问答系统 (RAG) 的后端集成。具体包括:
开发古籍图像上传与异步识别任务调度接口,对接底层 OCR 引擎,实现繁体竖排古籍的数字化。
负责文献的数据清洗与结构化处理(繁简转换、标点恢复、生僻字纠错)。为了支持问答,我还设计并实现了文本智能分块(Chunking)算法,将长篇文献切分为带有上下文语义的段落。
集成向量化模型与向量数据库,实现文献特征向量的存储与高效相似度检索。
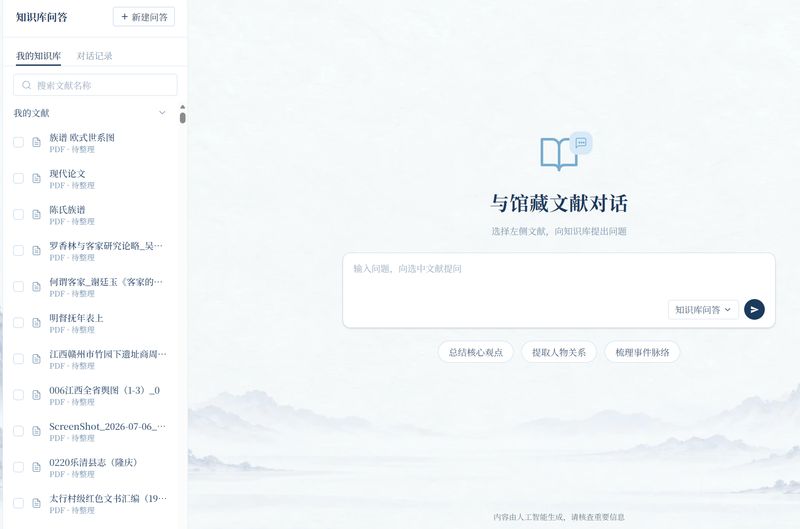
开发知识库问答(RAG)接口,对接大语言模型,并实现基于 SSE (Server-Sent Events) 的流式打字机效果输出,支撑前端“与馆藏文献对话”模块的落地。
2、项目使用了哪些技术栈、架构,实现上亮点、难点?
技术栈:基于 Java Spring Boot 框架构建后端,结合 MyBatis-Plus、Redis,引入 Spring AI (或 LangChain4j) 框架简化大模型对接,底层集成向量数据库(如 Milvus 或 RedisSearch)提供语义检索支持,使用 RabbitMQ 进行耗时任务的异步解耦。
架构与亮点:
亮点:成功落地了 RAG 架构,使得 AI 的回答完全基于馆藏真实古籍,极大地降低了通用大模型的“幻觉”现象;通过 SSE 长连接技术,实现了类似 ChatGPT 的流式流式打字机输出,大幅提升了用户的交互体验;针对古籍专门优化了 Prompt 模板,实现了如“提取人物关系”、“梳理事件脉络”等高级知识图谱抽取功能。
难点:古籍文献缺乏现代标点且大量存在双行小字夹注,导致 OCR 后的文本直接进行分块极易切断上下文语义。必须在 Java 层设计复杂的正则匹配与版面还原算法,才能实现精准的语义分块;此外,大模型接口响应较慢,需要设计复杂的异步任务队列和超时重试

评论