面向想读《传习录》、想用阳明心学思考日常烦恼的人。直接读原典门槛高:文言晦涩,术语多,读完也不知道和自己的事有什么关系。而让通用大模型直接扮演古人,又有几个问题:容易编造引文,说出现代心理学腔调,对方处于危机时也可能随意发挥。项目要做的是一场可信的“与古人对谈”:来访者说自己遇到的事,先生依学说回话,回答带出处和依据档位;模型引用的原文逐字核对,核对不过的不标出处;遇到危机类表达不走角色,改为固定的求助指引;经审核的对话可以公开,供旁人同读。后台用于运营、数据可视化,以及检索和人设的评测。
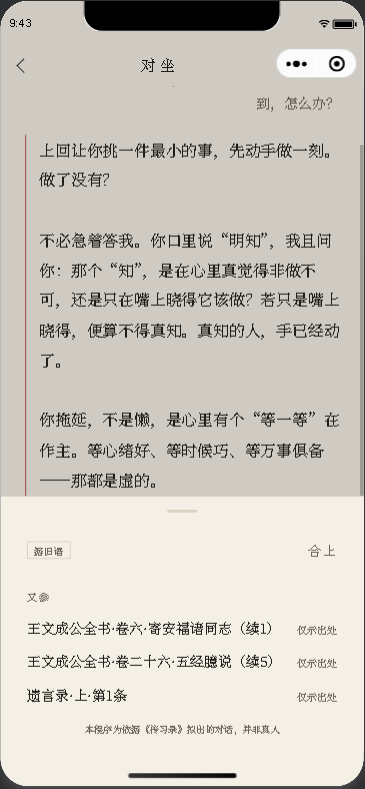
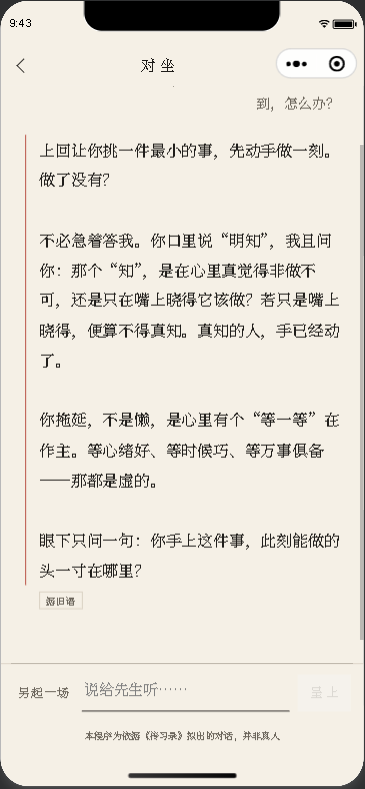
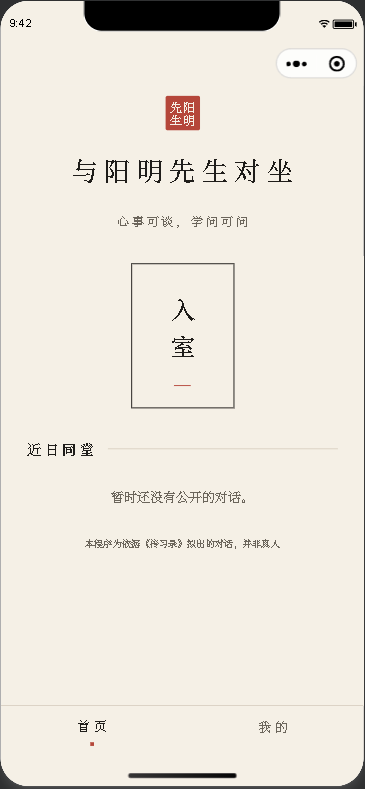
一、小程序端:与先生对坐,回答流式呈现;回答下方有“源旧语”出处面板,可公开的原文显示全文,不可公开的只显示出处;对坐记录、记忆与功课、公开对话详情(经审核的对话供旁人同读)、求助页和个人页。
二、AI 能力:
1. 检索增强回答:先从语料中检索与来访者处境相近的原文,再让模型依据原文作答。
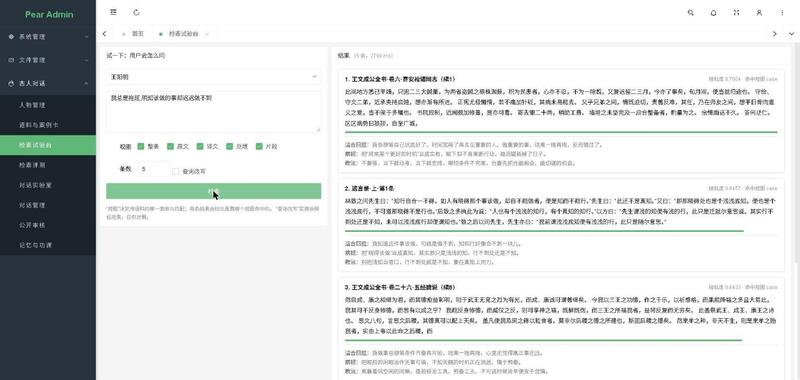
2. 多视图向量检索:一条语料生成原文加译文、仅原文、仅译文、案例卡(用现代口语写的处境)和长文片段等多个向量视图,取最高分,让“我总是拖延”也能找到“知行”相关的原文。
3. 查询改写:先让模型以人物口吻写一段简短回答并列出学说术语,用来弥合古今语体差,只用于检索,不展示给用户。
4. 引文校验:模型引用原文必须写在「」里,生成后逐字核对是否真出自检索到的原文,核对不过不标出处。
5. 安全层:关键词粗筛加模型细判,区分真正的轻生表达和口头禅,高风险时返回固定的求助指引,不入记忆、不可分享。
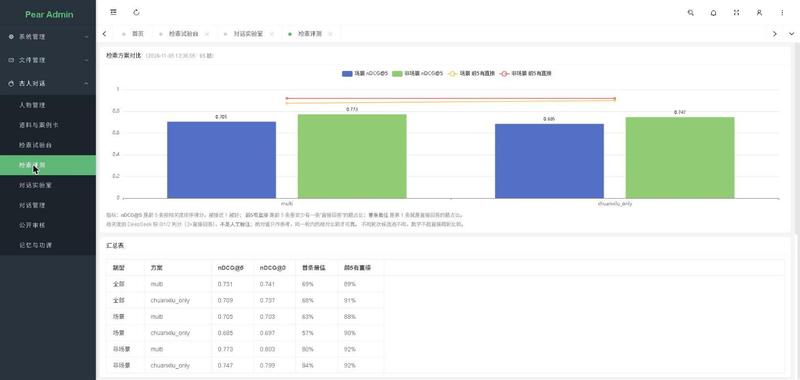
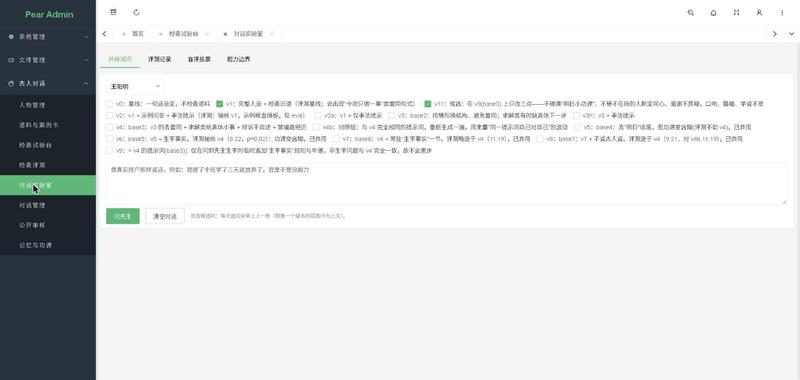
三、后台:人物管理、语料与案例卡、检索试验台、检索评测、对话实验室(多个人设版本并排试问、盲评投票、评测记录)、对话管理、公开审核。
四、人物包:新增一位古人只需新增一个目录,数据按人物隔离。
我们团队负责小程序、后端、AI 流程和部署的开发,项目以 Vibe Coding 的方式推进(借助 AI 辅助编程)。后端基于 Flask、SQLAlchemy 和 Pear Admin;小程序用 uni-app(Vue 3),回答用 enableChunked 流式接收,后端流做 ASCII 转义,避免分块边界切断 UTF-8 汉字。大模型和向量模型通过千帆的 OpenAI 兼容接口接入,调用封装在一处,换模型或厂商只改这里;向量用 qwen3-embedding-8b,语料只有几百到几千条,直接在内存里用 numpy 算余弦相似度。案例卡离线用大模型为每条语料标注处境、病根、药方、意象和回应手法,既用于检索,也用于让人物“神似”。对话流程按“安全评估、检索、组装提示词、生成、引文校验”分步,流式与非流式共用同一套准备和收尾逻辑。评测做了两套:检索评测用候选池加大模型 0/1/2 判分并缓存,算 nDCG@5,对比不同检索策略(在 65 题的评测集上整体 nDCG@5 约 0.73,判分由大模型给出,不是人工标注);人设评测让不同人设版本回答同一批来访者的话,先用自动指标,再成对盲评,淘汰了多个效果不如基线的版本。内容上只对外展示可公开原文,译文、注释和案例卡不出现在任何公开接口。使用 Docker 和 K8s 部署,配置走环境变量,密钥不入库;有后端 pytest 测试。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论