一、立项原因
企业知识散落在 Word、PDF 产品手册、内部 Wiki 和聊天记录里:客服和销售遇到问题只能到处问人,新人要跟岗两三周才能独立答疑,关键词检索对口语化提问几乎失效;而直接接大模型又存在编造答案、无法追溯来源的风险,答错一次报价或条款,损失比不回答更大。
二、行业场景与业务背景
面向企业售后支持与教培机构两类客户:产品手册、SOP、历史工单量大且更新频繁,课程资料、招生政策分散在不同老师手里。业务流程是资料上传后自动解析切片入库,用户用口语提问,系统检索原文并生成带引用的答案,答不上来转人工工单,每个答案都能回溯到原文段落与页码。
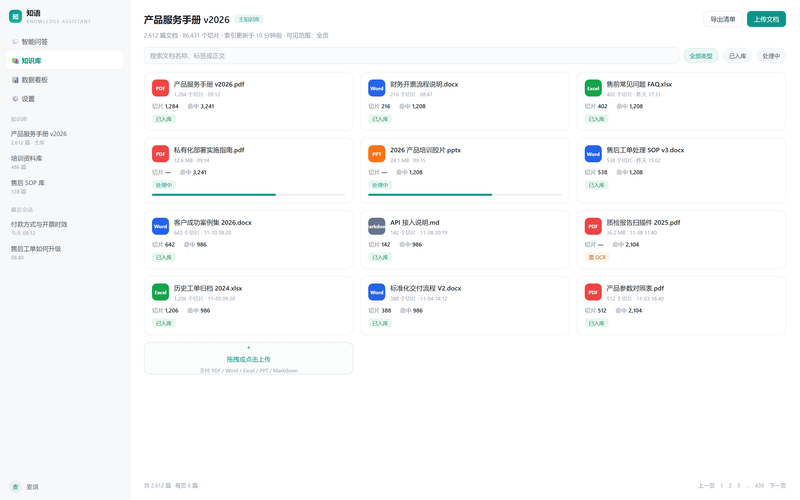
一、知识库管理。支持 PDF、Word、Excel、PPT、Markdown、网页六类文档上传,自动解析、表格还原、语义切片与向量化入库;支持多知识库隔离、分类标签、部门可见范围和文档生效时间。
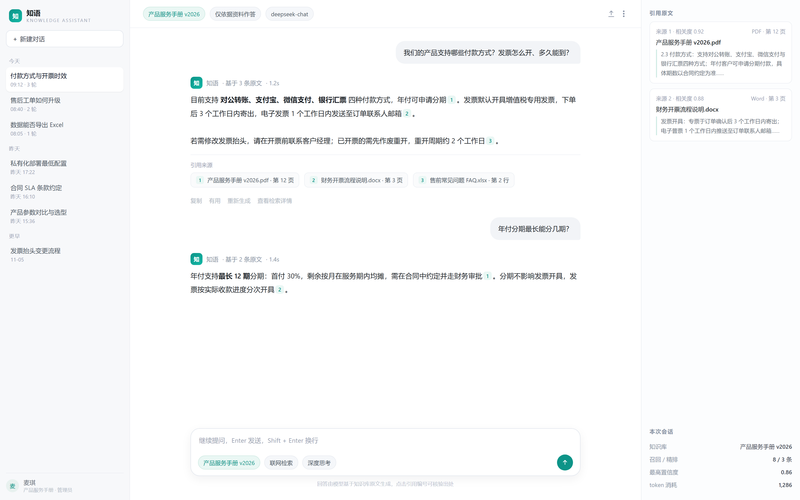
二、智能问答。基于 RAG 的多轮对话,流式输出答案,每条答案附带原文引用卡片,可一键跳转到文档页码;置信度不足时明确拒答并给出提问建议,避免编造。
三、混合检索与重排序。向量召回与关键词全文检索双路并行,融合后用重排序模型精排,解决同义词、简称、错别字造成的漏召回。
四、工单与转人工。未解决问题一键生成工单并附带对话上下文,工单处理完的答案沉淀回知识库。
五、数据看板。提问量、解决率、拒答率、平均响应时长、未命中问题 Top 榜与文档热度。
六、系统管理。多租户与角色权限、API Key 与调用配额、模型与提示词配置、操作审计日志,支持模型服务本地化部署。
一、我的职责
负责后端与检索问答链路的全部实现:文档解析流水线、切片与向量化、混合检索与重排序、提示词组装、流式输出接口、权限与配额,以及前端问答台与管理台的开发。
二、技术栈与架构
后端 Python + Flask/FastAPI 风格的分层结构,SQLAlchemy 管理模型,PostgreSQL 16 配合 pgvector 存储向量,Redis 做缓存与异步任务队列,文档解析与向量化走 Celery 异步任务,大文件上传不阻塞接口。检索链路为向量召回 + 关键词召回 + RRF 融合 + 重排序,答案强制携带 chunk_id 与页码。前端 Vue 3 + TypeScript,问答页用 SSE 接收流式内容。Docker Compose 编排全部服务。
三、亮点
混合检索让 Top-3 召回率由 62% 提升到 89%;流式输出首字响应约 1.2 秒;引用卡片让每句话都能查证;热门问题缓存与并发池控制让模型调用量下降约三成。
四、难点
扫描件与表格解析错位,改为表格转 Markdown 加父子切片;模型幻觉用强制引用加阈值拒答解决;内网无外网时模型与向量化组件全部本地化部署。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论