




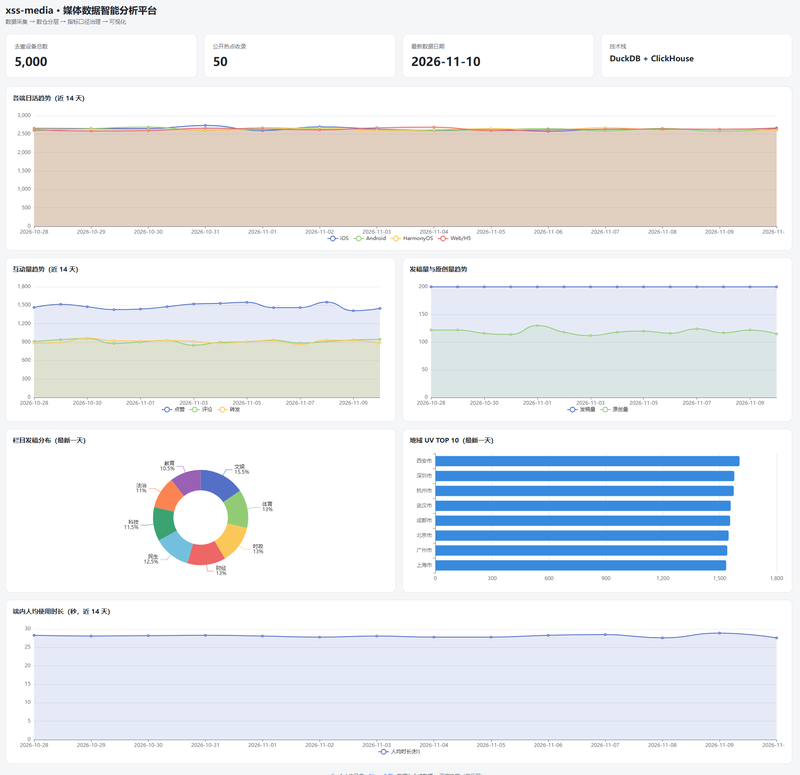
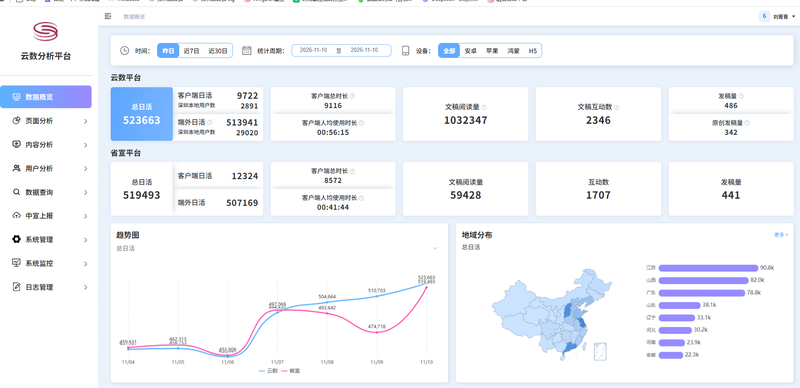
一个可运行、可讲解的个人作品集项目,演示一套**「数据采集 → 数仓分层 → 指标口径治理 → 自然语言查数」**的完整链路。
定位:媒体/内容行业数据智能平台的方法论最小可运行复现。方法论沉淀自真实生产环境(内容型 App 数据平台)的实践经验,代码完全重写,数据使用公开新闻源与合成数据,不包含任何生产数据与业务代码。
它解决了什么问题
业务方问"昨天的日活是多少、原创发稿量有没有涨",数据口径稍有偏差就会算错。传统 text2sql 直接让大模型写 SQL,错误率高。本项目的核心主张是:
查得准不是模型问题,是口径问题。
通过三层设计保证自然语言查数的准确性:
口径文档体系——术语表统一语言、指标指南统一选表规则、表级文档讲清"是什么/怎么加工/怎么消费"。
指标优先、明细兜底——标准指标优先查预聚合(ADS 层),答不了再回退明细重算,当天读实时、历史读预聚合。
Skill 驱动查数——把口径文档封装成 Agent Skill,让 Agent 走「读元数据 → 查口径 → 生成 SQL」的标准流程。



点击空白处退出提示
评论