

针对高校学生在兼职、二手交易、租房、游戏账号交易、冒充客服和校园贷等高频网络场景中容易遭遇诈骗的问题,项目面向校园网络素养教育与日常安全防护需求而立项。许多诈骗信息会以公开网页、帖子、短信截图或图片形式出现,传统关键词规则难以及时识别变形话术,普通学生也缺少可解释的风险判断依据。项目提供一款本地运行、只分析公开页面内容的检测工具,在不采集私聊、不上传隐私数据的前提下,提前发现可疑信息、展示判断证据并给出处置建议,降低校园诈骗识别门槛。


点击空白处退出提示



语言技术
Python、openCV、JavaScript、React、TypeScript系统类型
Web、Windows行业分类
人工智能、教育校园
针对高校学生在兼职、二手交易、租房、游戏账号交易、冒充客服和校园贷等高频网络场景中容易遭遇诈骗的问题,项目面向校园网络素养教育与日常安全防护需求而立项。许多诈骗信息会以公开网页、帖子、短信截图或图片形式出现,传统关键词规则难以及时识别变形话术,普通学生也缺少可解释的风险判断依据。项目提供一款本地运行、只分析公开页面内容的检测工具,在不采集私聊、不上传隐私数据的前提下,提前发现可疑信息、展示判断证据并给出处置建议,降低校园诈骗识别门槛。
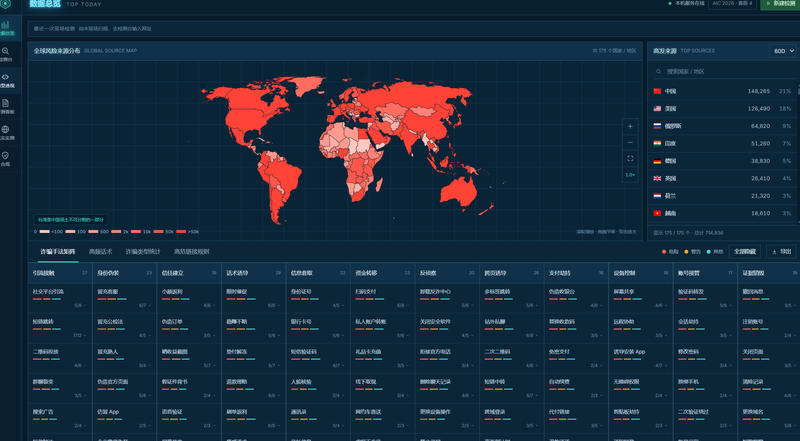
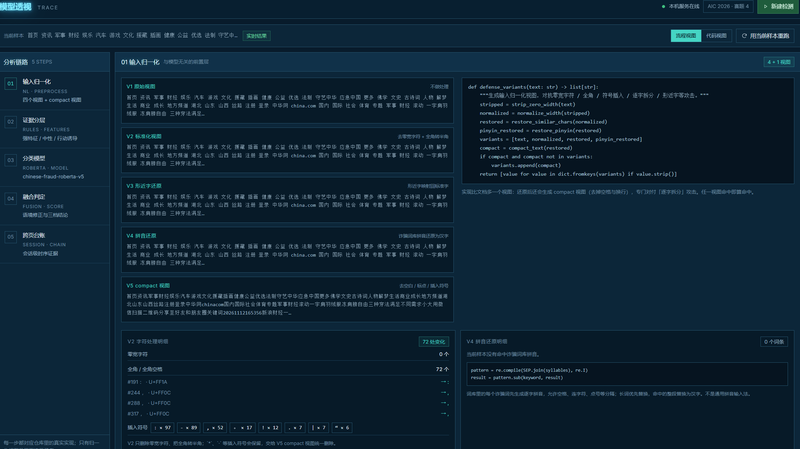
系统由浏览器插件、本地检测服务和评测模块组成。插件自动提取公开页面中的可见文字、图片与链接,在不改变用户浏览流程的情况下进行风险巡检;文本侧融合原创规则库与中文诈骗 RoBERTa 模型,覆盖刷单返利、虚假兼职、注销校园贷、冒充客服、杀猪盘、游戏交易、租房、钓鱼链接、投资理财、AI 换脸拟声等 14 类风险;图片侧通过 OCR 与二维码解析补充图文信号,链接侧结合 URL 结构与黑名单评分。检测结果通过风险分、风险等级、证据分层、关键词高亮和处置建议展示,并支持误报、漏报反馈。系统还会对谐音、拼音、拆字、零宽字符和全角字符等变形进行归一化,评测模块可量化 F1、攻击成功率与真实页面误报。
我独立完成从需求调研、方案设计到系统落地的全流程:构建 14 类校园诈骗规则库,基于公开授权的 TeleAntiFraud-28k 数据清洗并微调中文 RoBERTa 分类器,设计规则、模型、OCR、二维码与 URL 的多信号融合;使用 Python、PyTorch、Transformers 与标准 HTTP 服务搭建本机检测 API,以 React、TypeScript、Vite 制作演示站,并开发 Chrome/Edge MV3 插件实现自动巡检、风险侧栏与证据高亮。实现难点是抑制长网页误报并处理谐音、拼音、拆字等变形,我通过输入归一化、证据闸门和分块检测完成优化。提交版在 2,157 条留出集上 F1 为 0.9983,10 类对抗样本 ASR 为 4.95%,15 个真实页面误报 0/15,长页面 P95 为 513.7 ms,并提供模型、数据与复现脚本。

评论