

烟草商业企业的人事数据分散在花名册、培训、任职和奖惩多张表中。业务人员要看部门人数、年龄结构、学历分布或选拔线索时,通常得找技术人员写 SQL,口径还不统一。本项目面向市局及下属公司的人事分析场景,把自然语言提问接到受控的人事库上:日常交流不查询业务数据,查数和写报告必须走只读查询,报告中的数字要能回溯到原始查询结果。要解决的问题是,让业务人员在同一个对话里完成问数、看板和洞察报告,同时避免模型直接编造人事数字。


点击空白处退出提示



烟草商业企业的人事数据分散在花名册、培训、任职和奖惩多张表中。业务人员要看部门人数、年龄结构、学历分布或选拔线索时,通常得找技术人员写 SQL,口径还不统一。本项目面向市局及下属公司的人事分析场景,把自然语言提问接到受控的人事库上:日常交流不查询业务数据,查数和写报告必须走只读查询,报告中的数字要能回溯到原始查询结果。要解决的问题是,让业务人员在同一个对话里完成问数、看板和洞察报告,同时避免模型直接编造人事数字。
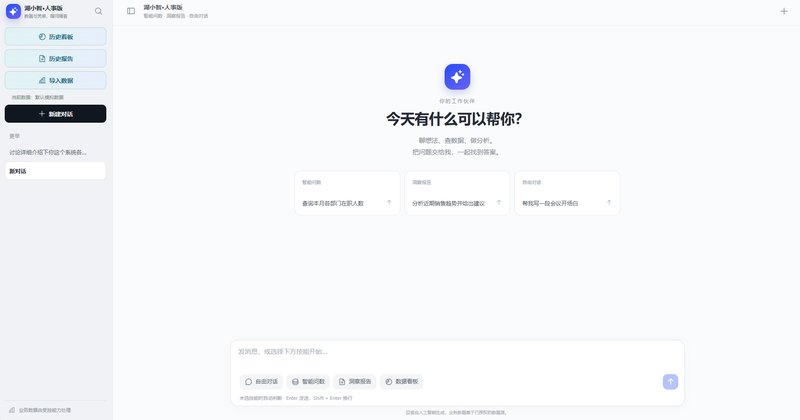
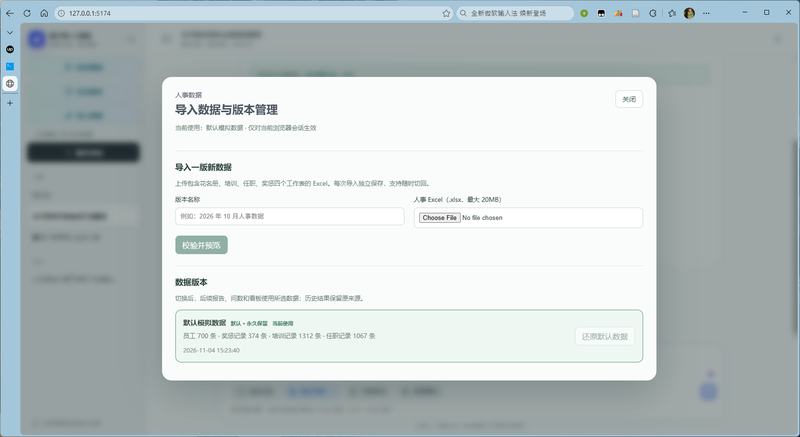
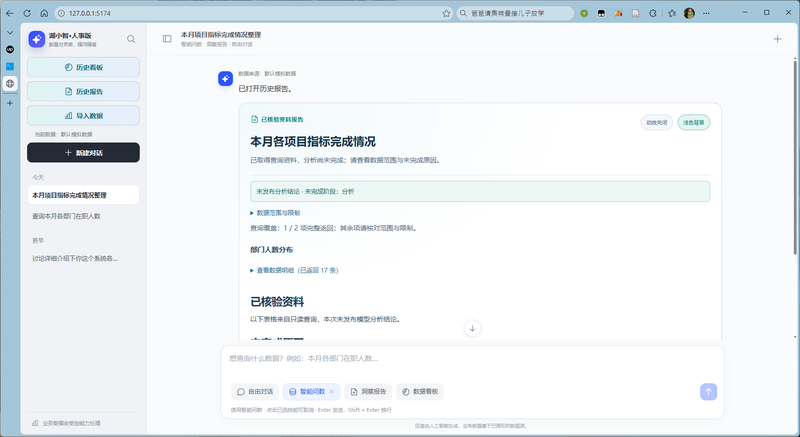
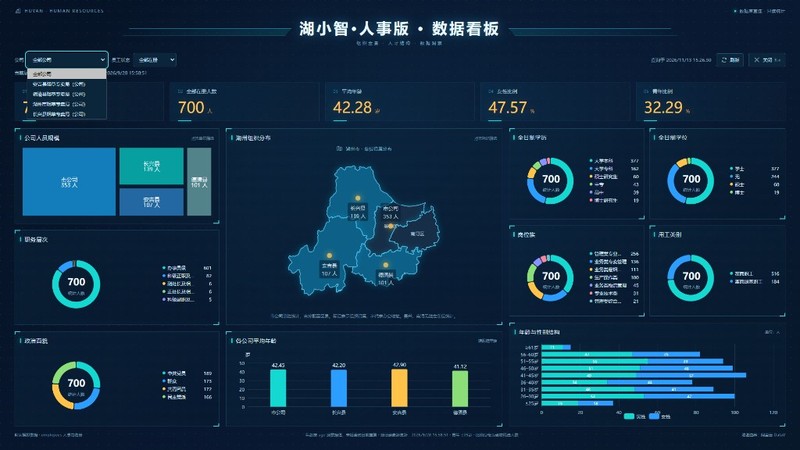
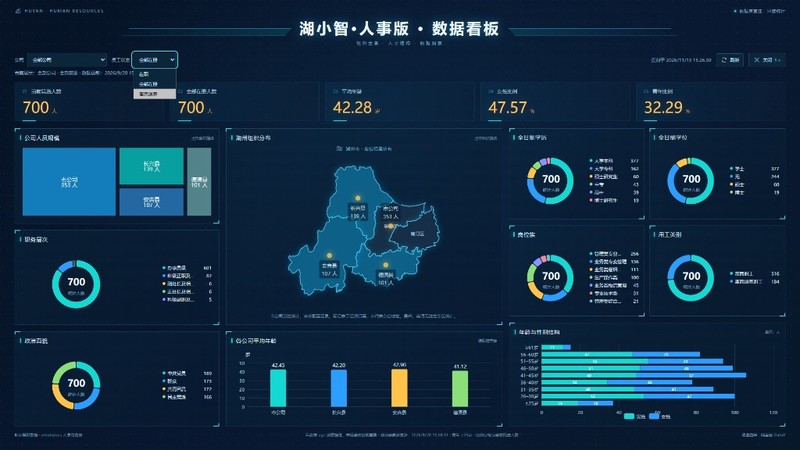
系统在同一会话里提供四种能力。聊天只处理日常交流,不访问企业数据。智能问数把问题转成一条只读 SQL,执行后立即展示表格,再根据返回结果生成解读和图表;解读失败时可以在原数据上重试。洞察报告按规划、取数、分析校验和排版输出,数字、指标和人员名单由程序对照原始行核验,校验失败时只保留已查到的资料,不发布未核实结论。人事看板用固定统计展示在册规模、年龄、学历和职务层次,不把个人明细交给模型。系统还支持用 Excel 导入新的人事数据版本,问数、报告和看板可以按版本切换。主要优点是模型只负责理解和表达,关键数字由程序回填,查询账号和写入账号分开。
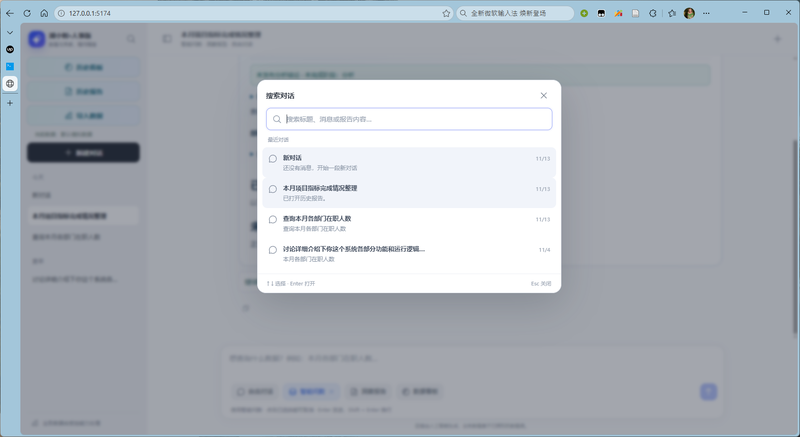
我使用 Python、FastAPI 和 React 搭建前后端,数据库使用 MySQL。前端是单页对话应用,用 Vite 开发;报告通过服务端事件流式返回,会话、报告和查询结果保存在浏览器 IndexedDB。后端按聊天、指标知识、智能问数、洞察报告、人事看板和数据版本拆成独立模块。问数会拦截写入类语句,并用只有查询权限的数据库账号执行。报告把一个问题拆成多次查询,分析文字里的数字先用占位符,发布前再按查询结果回填单位、比例和名单。实现上的难点是模型输出不稳定,需要处理结构化结果校验、输出被截断后的重试,以及没有数据时不生成报告。导入新版本时会单独建库,避免覆盖默认人事库。模型通过兼容 OpenAI 的接口接入,可以换成内网大模型或本机模型。

评论