系统类型
Web、算法模型行业分类
人工智能、企业服务演示地址
http://123.207.216.229:8000/
1、立项原因:企业内部工业手册、产品文档普遍几百页,传统 RAG 方案在真实文档上存在三大硬伤——跨页段落被切断导致语义残缺、目录页因满屏关键词被高优先级召回、返回的 PDF 物理页码与手册印刷页码不一致导致用户翻不到原文。业务方拿到答案却无法定位原文,直接判定系统不可用。本项目旨在做一套能真正上生产的私有化 RAG 问答系统。
2、目标用户:需要查阅长篇技术手册的工程师、企业知识库管理员。
3、使用场景:上传工业手册 PDF,问答式检索维修步骤、参数指标,并要求答案带可核对的印刷页码溯源。
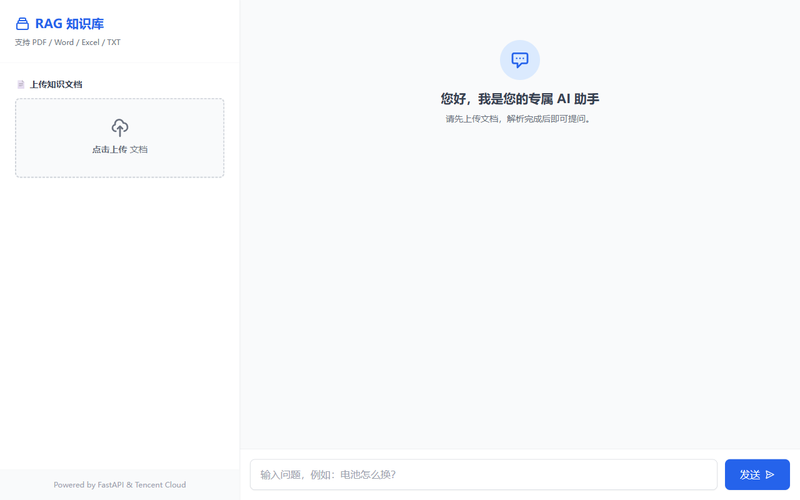
1、文档解析与清洗:支持 PDF/Word/Excel/TXT 上传,正则清洗 + 无效块过滤,剔除目录页与封底联系方式等噪音段落,298 页手册的 Chunk 从 347 压到 136。
2、段落锚点切分:基于语义单元切分并做页码锚点注入,解决长文本跨页截断,长句测试集跨页召回失败率从 100% 降至 0%。
3、双路召回融合:向量语义检索 + BM25 关键词检索并行召回,手写修复原生 RRF 因对象内存地址不同无法去重的缺陷。
4、精准页码溯源:设计物理页与印刷页动态映射,返回手册实际印刷页码,做到"答得对、翻得到"。
5、防幻觉治理:Prompt 强约束 + 兜底清洗,抑制本地小模型幻觉。
6、异步高并发:run_in_threadpool 将同步 LLM 推理移出事件循环,本地 CPU qwen2.5:3b 端到端 10 秒内。
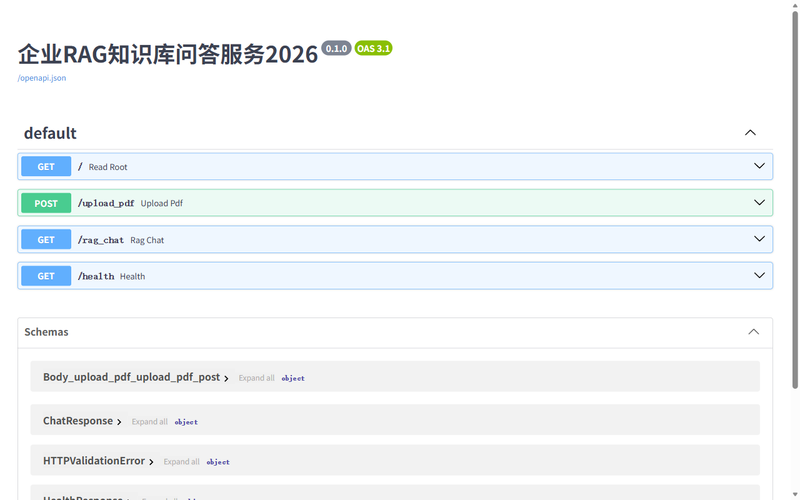
7、工程化交付:FastAPI 分层架构 + Pydantic 数据契约 + Docker Compose 一键部署。
1、我负责的部分:架构设计、数据管道、召回融合、异步改造、Docker 化部署,全部独立开发完成。
2、关键技术取舍:本地 Ollama 小模型 vs 云端大模型——选本地,换隐私与零调用成本,代价是延迟,因此把检索加生成压进 10 秒并加防幻觉约束;Chunk 数量 vs 噪声——宁可剔除 60% 低质块,也不让向量库被目录页污染;页码溯源用物理页与印刷页动态映射,而非简单取 PDF 页索引。
3、质量验证:建立固定测试集量化召回失败率,每条修复都配可复现测试用例,用数据确认修好,而不是看日志"好像没报错"。
4、技术栈:FastAPI、LangChain、ChromaDB、BM25、Ollama/DeepSeek、Docker。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论