

面向独立开发者及软件产品研究中的需求发现与商业机会分析场景。
Reddit等社区包含大量用户对软件产品、业务流程和现有解决方案的讨论,但数据分散在帖子和评论中,存在噪声多、重复问题多、人工阅读和归类成本高等问题。
本项目通过自动化数据处理与大模型分析,从非结构化社区讨论中提取问题线索、整理需求证据,并生成结构化研究资料,辅助软件产品选题与商业可行性判断。


点击空白处退出提示



面向独立开发者及软件产品研究中的需求发现与商业机会分析场景。
Reddit等社区包含大量用户对软件产品、业务流程和现有解决方案的讨论,但数据分散在帖子和评论中,存在噪声多、重复问题多、人工阅读和归类成本高等问题。
本项目通过自动化数据处理与大模型分析,从非结构化社区讨论中提取问题线索、整理需求证据,并生成结构化研究资料,辅助软件产品选题与商业可行性判断。
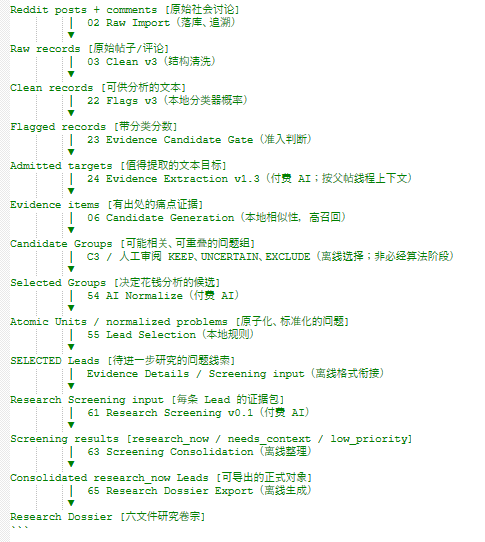
1. **社区数据采集与导入:** 获取Reddit指定社区的帖子和评论,完成原始数据存储与批量导入。
2. **数据清洗与初步筛选:** 清理无效及低价值内容,利用文本分类模型和业务规则筛选可能包含需求信号的数据。
3. **AI需求证据提取:** 调用大模型分析帖子及评论,结构化提取用户问题、痛点、现有解决方式和付费意愿等信息。
4. **相似需求候选生成:** 使用TF-IDF等文本相似度方法,将可能描述相同问题的证据组织为候选组,供后续语义分析使用。
5. **需求归一化与研究筛选:** 对相似问题进行语义整理和候选评估,形成可供进一步研究的需求线索。
6. **研究结果输出:** 生成结构化研究档案,便于对需求背景、解决方案和商业可行性进行后续分析。
7. **批处理与结果追踪:** 记录任务运行状态、异常及处理结果,支持分阶段执行与数据核查。
独立负责系统方案设计、数据模型设计、Python处理程序开发、大模型接口集成及数据处理流程实现。
采用Python和PostgreSQL构建本地数据处理系统,将原始数据导入、清洗、分类筛选、AI证据提取、候选生成及研究输出拆分为独立处理阶段,通过数据库保存中间结果和处理状态。
在数据筛选与候选生成阶段结合规则、文本分类模型及TF-IDF相似度方法;在语义提取与分析阶段调用LLM API,并通过结构化输出校验、异常记录和批处理控制提高执行过程的可检查性。
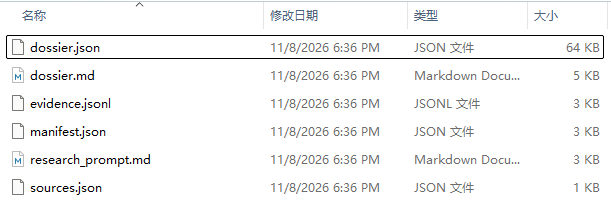
系统已完成实际数据处理与研究流程,基于18个Reddit社区的数据生成了234份Research Dossiers,用于后续商业机会分析。项目目前为个人研究工具,尚未作为商业服务运营。

评论