

本项目面向有限算力条件下的中文大语言模型学习、训练验证和本地部署需求,构建轻量级中文对话模型。项目覆盖模型结构设计、数据处理、预训练、监督微调、LoRA 参数高效微调、对话效果验证以及本地推理部署,适合教学实验、技术验证和轻量级智能问答等场景。


点击空白处退出提示



本项目面向有限算力条件下的中文大语言模型学习、训练验证和本地部署需求,构建轻量级中文对话模型。项目覆盖模型结构设计、数据处理、预训练、监督微调、LoRA 参数高效微调、对话效果验证以及本地推理部署,适合教学实验、技术验证和轻量级智能问答等场景。
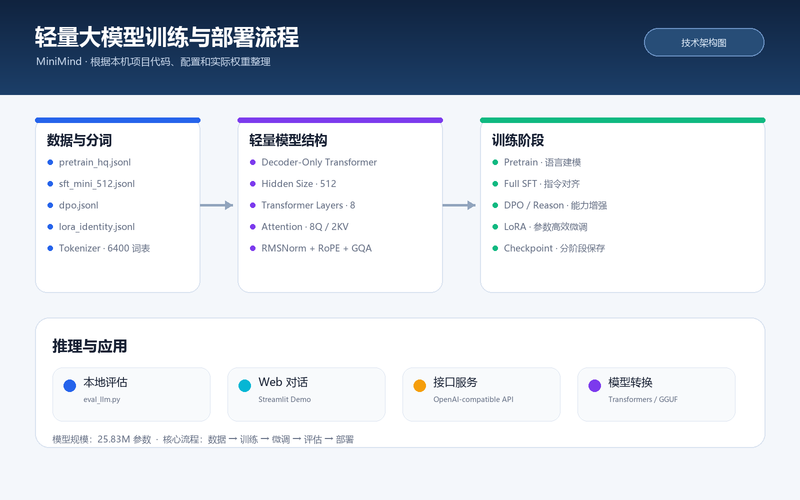
1. 模型构建:基于 PyTorch 从零搭建 Decoder-Only Transformer,引入 RMSNorm、RoPE 旋转位置编码等结构,并配置自定义 6400 词表 Tokenizer。
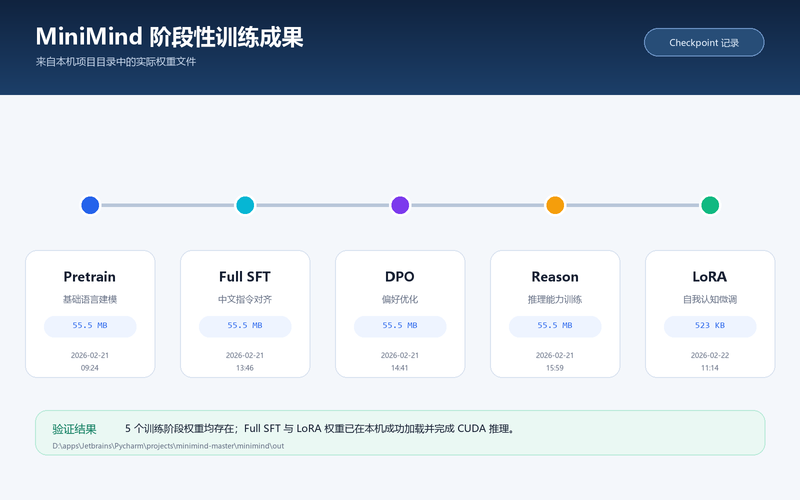
2. 训练与微调:支持模型预训练、SFT 监督微调和 LoRA 参数高效微调,可在单卡环境下完成轻量级模型训练。
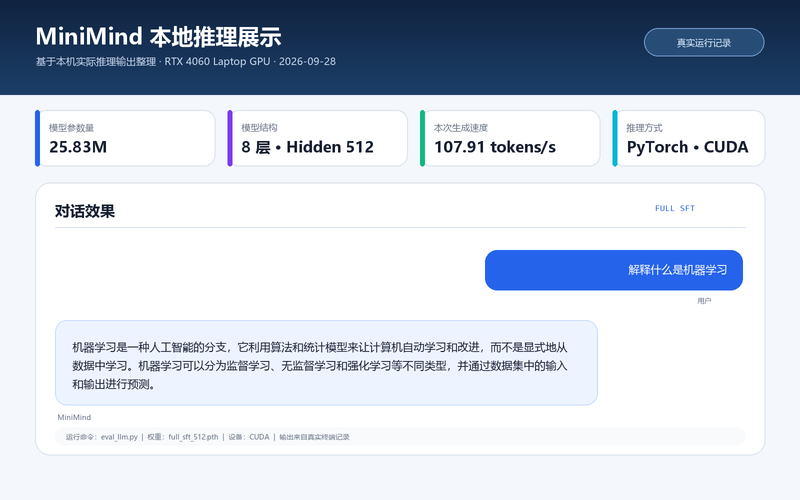
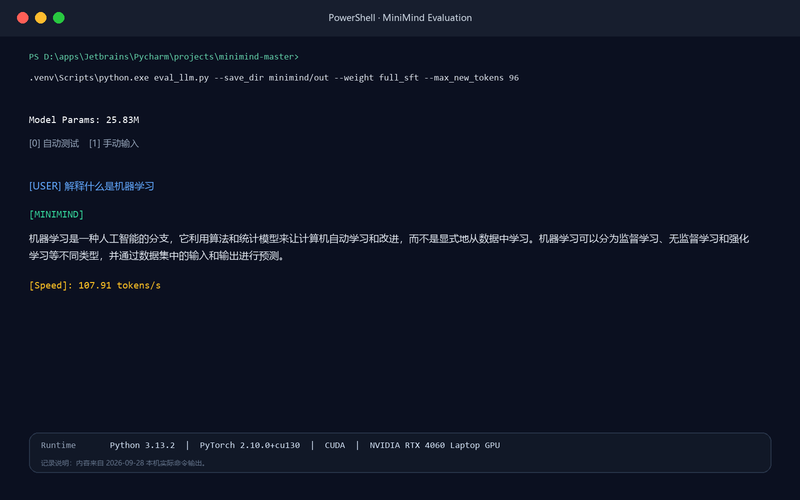
3. 效果验证:通过中文对话样例测试模型的指令理解和回答能力,并对不同参数规模模型的推理效果进行比较。
4. 推理部署:适配 vLLM、llama.cpp 和 Ollama 等推理方式,可用于本地对话、接口调用和后续应用集成。
5. 模型转换:完成模型权重与部署格式转换,验证不同推理后端下的模型加载和输出流程。
我主要负责模型结构搭建、训练流程配置、LoRA 微调、推理验证和本地部署。
基于 PyTorch 完成 Decoder-Only Transformer 的核心模块开发与调试,集成 RMSNorm、RoPE 和自定义 Tokenizer;在单卡 NVIDIA 3090 环境下完成预训练、SFT 和 LoRA 微调链路验证。
针对全参数微调显存占用较大的问题,引入 LoRA 进行参数高效微调。25.8M 参数规模模型单次训练约 2.1 小时,单次训练成本约 3 元。完成中文对话能力测试和不同参数规模的效果比较,并适配 vLLM、llama.cpp、Ollama,实现本地推理、API 服务及模型格式转换。

评论