

业务库里已经有算法目录、监测指标和设备运行数据。业务人员查取数据,需要用SQL查询或涉及多表关联的问题,也不知道一次提问该查表、做回归,还是调用空调能耗模型。本项目把问数做成 MCP 服务:对话模型只负责理解问题,查询、取数和预测都交给单独注册的工具。目前实际覆盖两类场景,一类是水利与监测类指标的自然语言查询,一类是根据冷机、水泵运行数据预测中央空调冷水泵功率。


点击空白处退出提示



业务库里已经有算法目录、监测指标和设备运行数据。业务人员查取数据,需要用SQL查询或涉及多表关联的问题,也不知道一次提问该查表、做回归,还是调用空调能耗模型。本项目把问数做成 MCP 服务:对话模型只负责理解问题,查询、取数和预测都交给单独注册的工具。目前实际覆盖两类场景,一类是水利与监测类指标的自然语言查询,一类是根据冷机、水泵运行数据预测中央空调冷水泵功率。
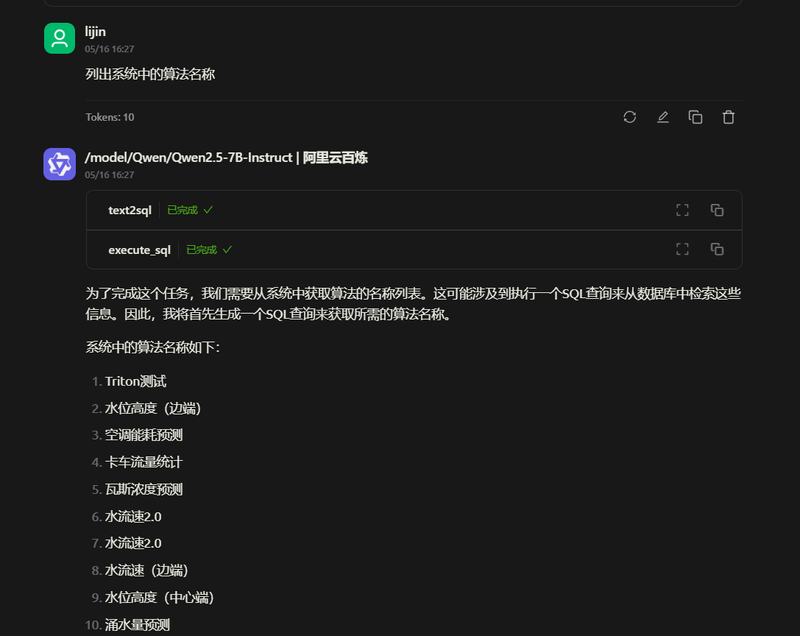
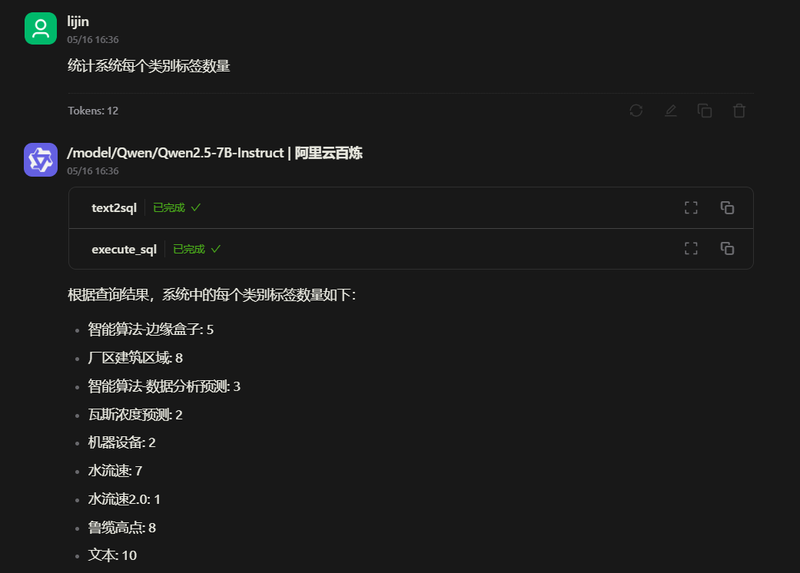
服务注册了五个工具。text2sql 按库表结构把问题写成 PostgreSQL,execute_sql 执行并返回结果;data_process 读取上传的 csv/xlsx 并整理成模型输入;common_models 按目标变量选择算法,分类用随机森林,回归用线性回归;aircondition_models 从库中取出空调能耗相关字段,调用已有 Transformer 预测冷水泵功率。对话侧可以接 Qwen2.5-7B 或 DeepSeek-V3,由模型决定调用哪些工具。已跑通的示例包括:用自然语言列出系统中的算法名称、统计各类别数量、对上传表格训练回归并给出测试样本预测,以及「预测空调冷水泵功率」时连续调用查数和空调模型。通用回归那次用的是只有 19 条记录的房价示例,只说明工具链能走通,不能当作预测精度。
我负责把问数拆成可注册的 MCP 工具,避免让大模型直接连库或自行编造查询结果。表结构在服务启动时生成一份 M-Schema,供 Text2SQL 使用;模型侧只做小模型分流,分类与回归分开,空调功率走单独的时序模型,数值由工具返回后再组织成回答。实现从业务理解、数据理解、数据准备、建模、模型评估和模型发布的全流程,开发过程中严格遵守CRISP-DM准则。


评论