【立项原因】网文作者与深度读者长期面临工具割裂的痛点:阅读用一套软件、写作又用另一套,抄写练笔、素材摘录、世界观设定、拆书学习各自分散,数据无法互通,反复在多个工具间导出导入,效率低下且容易丢失。市面上缺少一款能把"读—抄—创—学"全链路打通的一体化工作台。
【行业场景与业务背景】面向网络文学创作与阅读场景:读者导入 TXT 小说进行沉浸式阅读、批注、摘录与抄写练笔;创作者从零建书、分卷管理章节、边写边自动保存,同时维护角色卡、设定卡、三级大纲等创作资料;进阶用户借助 AI 拆书对爆款作品做结构化拆解(角色/世界观/大纲/黄金开篇/写作公式/避雷诊断),沉淀为可复用的个人知识库,并用费用统计面板监控 API 消费。整套流程打开浏览器即可完成,支持 PWA 离线安装,兼顾桌面与平板使用。
项目共 10 大功能模块、130+ 项已实现功能:
1. 书架管理:TXT 导入(自动解析章节)、拖拽导入、新建创作书、书籍卡片、全量备份/恢复、本地文件持久化。
2. 阅读器:段落渲染、字号行距调节、阅读进度追踪、选中文本摘录、章节笔记、阅读时长统计。
3. 编辑模式:TipTap 富文本编辑、批注面板、焦点模式、自动保存、恢复原文。
4. 抄写模式:左右分栏对照抄写、自动计时器、每日目标进度条、抄写历史与连续天数统计。
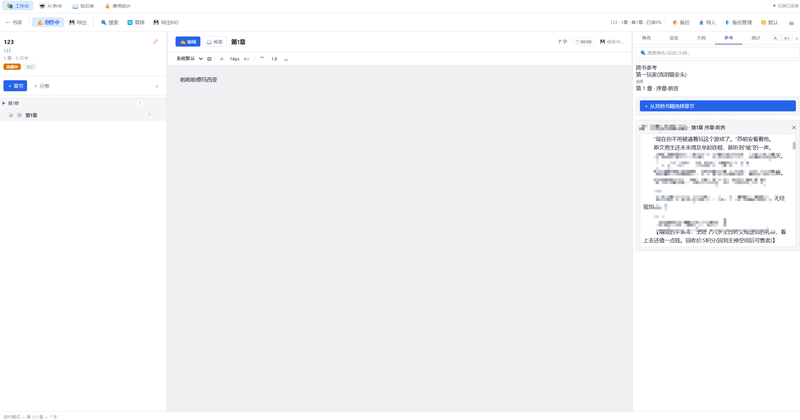
5. 创作工作区:三栏布局(卷章树/编辑器/参考面板)、分卷与章节管理、角色卡与关系网络、设定卡、三级大纲、跨书参考引用、写作仪表盘与日历、校对辅助。
6. 摘录管理:统一摘录模型、搜索与标签过滤、跳转原文、一键复制、导出。
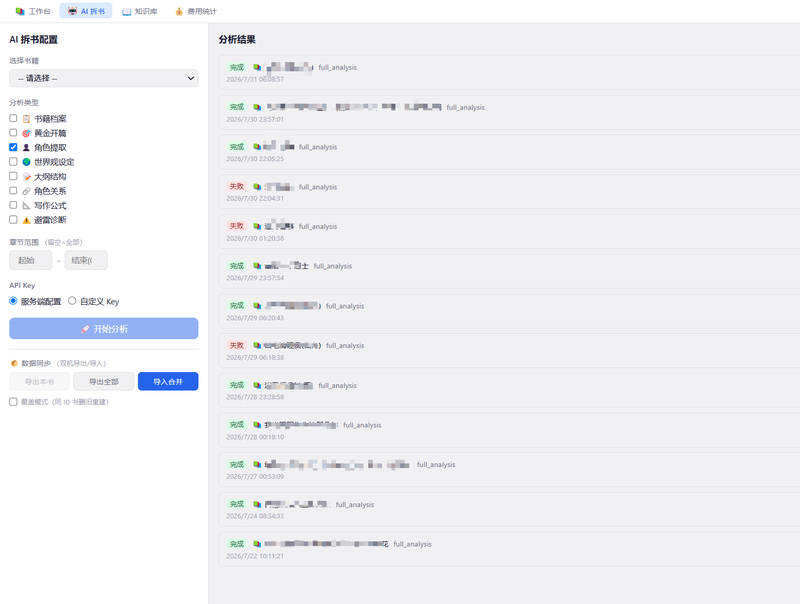
7. AI 拆书:8 种分析类型、任务进度轮询、结果智能渲染、一键入知识库、追问式分析、报告下载。
8. 知识库:按书分组展示、中文全文搜索(ngram)、外部结果导入、按书/全量导出、条目关联。
9. 费用统计:总览卡片、按模型/书籍/日期/类型多维统计、任务级调用明细、日消费预警。
10. 全局通用:全文搜索、批量查找替换、多格式导出(TXT/Markdown/HTML)、自动备份、三套主题切换、键盘快捷键、PWA 离线安装、跨设备数据同步。
【我负责的任务】独立完成全栈的设计与开发,包括:前端 73 个源文件(44 个 Vue 组件、20 个 Composable、5 个 Pinia Store)、后端 Express 服务(9 个路由模块、65 个 API 端点、4 个业务服务)、MySQL 数据库设计(14 张表)、AI 拆书与知识库集成、DeepSeek API 对接与费用核算,以及 PWA 打包与 Nginx 部署。
【技术栈与架构】
· 前端:Vue 3 + Pinia + Vite + vite-plugin-pwa,富文本编辑器基于 TipTap(ProseMirror 内核)。
· 后端:Node.js + Express + mysql2(连接池),dotenv 配置管理。
· 数据库:MySQL 8.x(utf8mb4),子表通过 ON DELETE CASCADE 关联书籍主表。
· 架构:前后端分离,采用无路由的状态驱动视图切换(两级:工作区分区 + 工作台内部模式)。
【实现亮点与难点】
1. 三层存储架构:内存(Vue reactive)→ IndexedDB → File System Access API,通过分级防抖(500ms/1s/3s)落盘,FS API 不可用时自动降级为纯 IDB,保证跨浏览器数据不丢失。
2. 离线优先:PWA + Service Worker 预缓存静态资源,断网仍可用,支持安装到桌面/平板。
3. AI 拆书工程化:长文本分批处理 + 两阶段大纲重构 + 任务进度轮询 + 僵尸任务自动清理,每次调用写入用量日志并按官方价目核算费用,支持跨设备按 uuid 去重同步。
4. 攻克多个 Vue 响应式陷阱:computed 引用追踪需 [...arr] 重建引用、userdata 必须 reactive() 包装、创作书与导入书内容读写路径分支、
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论