




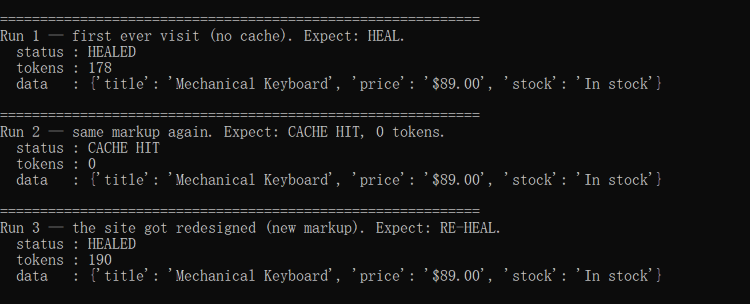
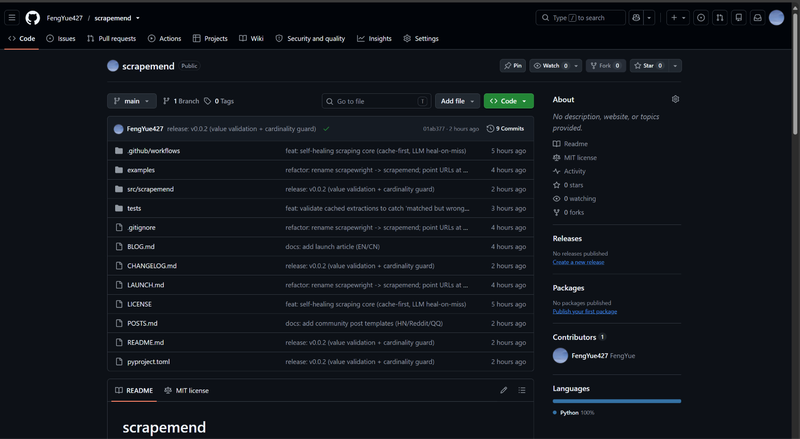
scrapemend 是一个 Python 网页数据提取库,核心思路是「选择器失效等于缓存未命中,而非程序崩溃」。主要功能:1)用自然语言描述要抓取的字段,无需手写选择器;2)优先使用缓存的选择器提取,零大模型开销;3)当某字段匹配失败或匹配到错误节点时,自动调用 LLM 重新生成选择器并缓存,实现自愈;4)提取前对 HTML 预清洗,将 prompt 体积压缩 90% 以上以降低成本;5)内置值校验与基数检查,拦截「匹配上但取到错误数据」的隐蔽故障;6)支持 OpenAI、DeepSeek 等多模型适配,内置离线模式。项目已开源(MIT)并发布至 PyPI,可通过 pip install scrapemend 安装。



点击空白处退出提示
评论