

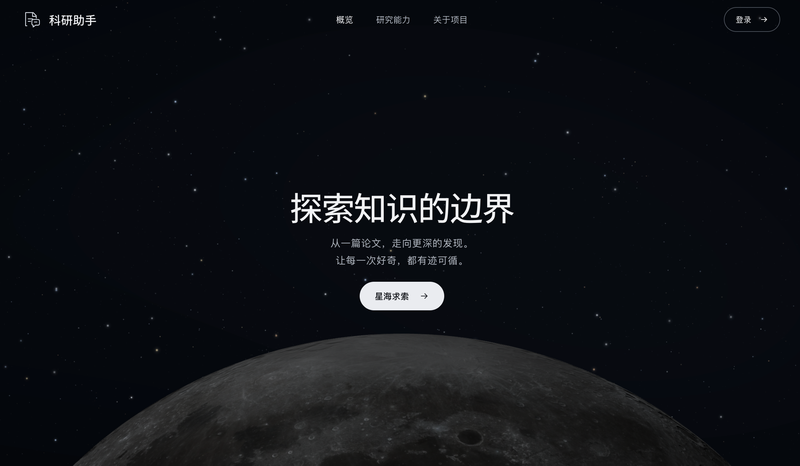
项目面向科研学习中英文论文阅读耗时、跨段落查找信息困难、图表数据难以定位,以及多轮交流偏好无法持续保留等问题,搭建个人科研知识助手。主要应用于高校学生、科研人员的文献阅读、方法理解、实验参数查询和研究资料整理,通过可追溯的论文问答与个性化交互,提高文献利用和信息获取效率。


点击空白处退出提示



项目面向科研学习中英文论文阅读耗时、跨段落查找信息困难、图表数据难以定位,以及多轮交流偏好无法持续保留等问题,搭建个人科研知识助手。主要应用于高校学生、科研人员的文献阅读、方法理解、实验参数查询和研究资料整理,通过可追溯的论文问答与个性化交互,提高文献利用和信息获取效率。
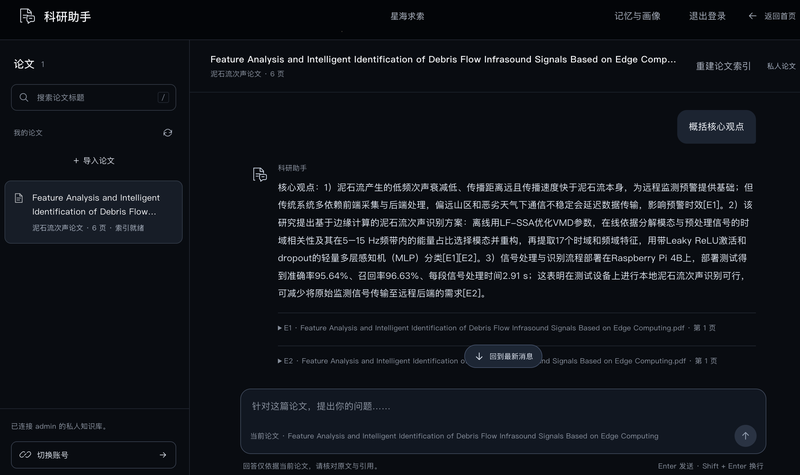
项目包含注册登录、私有知识库、论文导入处理、论文智能问答、长期记忆、用户画像及会话管理等模块。用户上传论文后,系统自动完成解析、结构化切块、向量化和索引建立;提问时结合关键词与向量检索、相关性重排及证据充分性判断,生成带原文引用的回答,并支持关联论文图片和表格。系统还能从对话中提炼长期偏好,按用户保存并用于后续回答,支持记忆增删改查、历史会话恢复和长对话自动压缩。
我负责“星海求索”科研助手的需求分析、技术选型、后端架构设计、插件集成及功能验收,并完成前后端接口联调。项目采用 Python、FastAPI、DeepSeek Harness、PostgreSQL、Milvus 和 Docker,集成 MinerU 文档解析、嵌入模型、重排模型及 Jev 意图判断。实现亮点包括父子分块检索、图表关联与来源引用、用户偏好自动学习、会话持久化、上下文自动压缩和 SSE 流式输出。主要难点是多用户数据隔离、中文问题与英文论文的检索对齐,以及记忆候选的准确筛选。

评论