

让扫描件、PDF、图表这类“能存不能问”的文档,变成可检索、可追溯、可私有化的知识库。
扫描件、图片无法检索 内置 RapidOCR / dots.ocr / 云端视觉模型三种解析方式,统一入库
长文档定位难 按标题层级切块,保留章节、页码、图片位置
大模型回答不可信 只基于检索结果回答,返回来源卡片
没有资料也硬答 无命中时明确回复“没有找到”,不编造
数据不能出内网 Docker 私有化部署,支持本地模型和本地 OCR


点击空白处退出提示



让扫描件、PDF、图表这类“能存不能问”的文档,变成可检索、可追溯、可私有化的知识库。
扫描件、图片无法检索 内置 RapidOCR / dots.ocr / 云端视觉模型三种解析方式,统一入库
长文档定位难 按标题层级切块,保留章节、页码、图片位置
大模型回答不可信 只基于检索结果回答,返回来源卡片
没有资料也硬答 无命中时明确回复“没有找到”,不编造
数据不能出内网 Docker 私有化部署,支持本地模型和本地 OCR
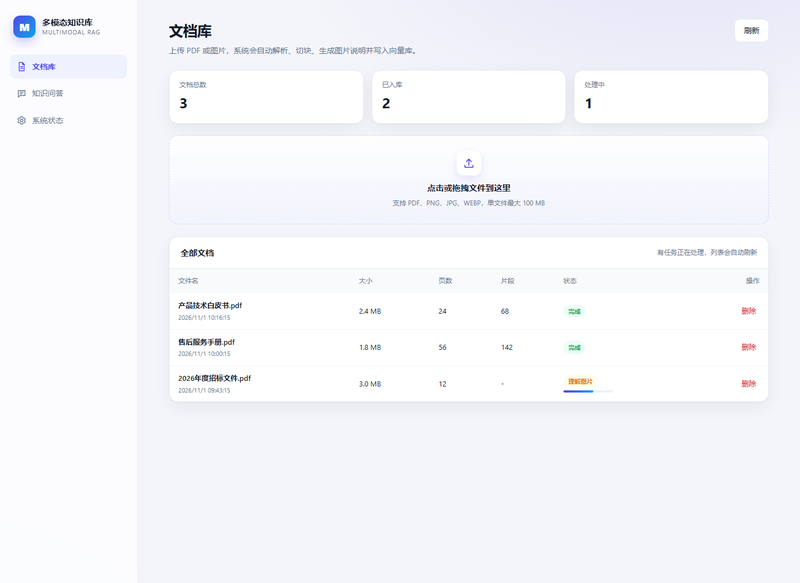
文档上传
输入 PDF/PNG/JPG/JPEG/WEBP,默认最大 100 MB;校验类型和大小,保存原件,创建记录并启动后台任务;返回文档 ID 和状态。类型不支持返回 415,超限返回 413。
解析与 OCR
数字版 PDF 直接提取文本;扫描页用 RapidOCR;复杂版面可切 dots.ocr + vLLM;无 GPU 可用云端视觉模型逐页转写。统一输出“每页 Markdown + 图片”。
切块与入库
按 # / ## / ### 切 section,正文按配置长度和重叠切块,图片单独成为 image chunk 并由视觉模型生成描述;批量向量化后写入 Milvus,状态变为 ready。失败会记录原因并清理残留向量。
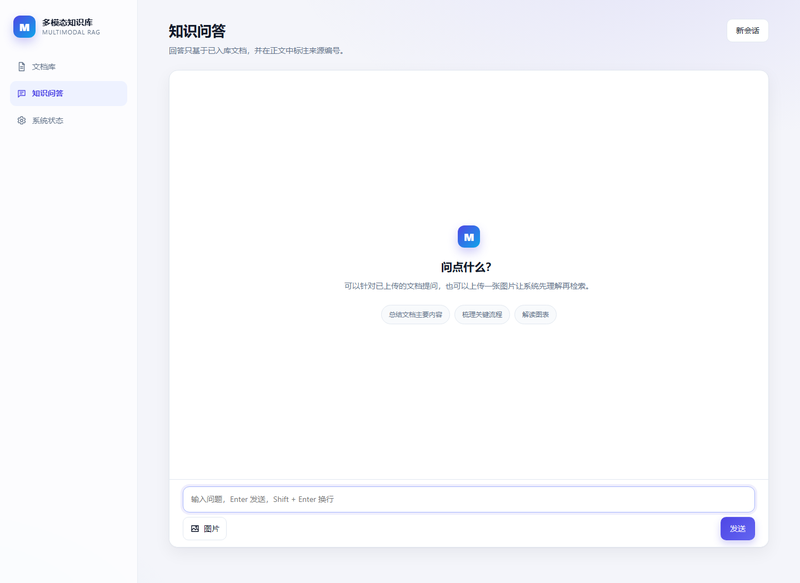
知识问答
问题向量化后,Milvus 做稠密 + BM25 混合检索,取 Top-K,去重后拼成带编号的上下文;模型只基于上下文回答,正文标注来源编号,返回文件名、章节、页码和原图。支持 SSE 逐字输出和多轮对话。
完整实现:技术选型与架构设计,FastAPI 服务与 REST / SSE 接口,PDF 与图片解析及三种 OCR 引擎适配,标题感知切块与图片理解入库,Milvus 稠密 + BM25 混合检索,带出处引用和流式输出的问答链路,以及管理前端、Docker 部署和自动化测试。
技术栈:Python、FastAPI、Milvus 2.6、PyMuPDF、RapidOCR / dots.ocr、OpenAI 兼容多模态模型、SQLite、Docker Compose、原生 JavaScript。
架构:上传后异步执行“解析 → 切块 → 图片描述 → 批量向量化 → 写入 Milvus”;查询时先做稠密与稀疏混合检索,再让大模型只基于检索到的上下文生成答案并标注来源编号。
实现亮点:1)图片先由视觉模型生成描述再写入向量库,用一套文本 Embedding 实现图文混合检索;2)把标题层级写进每个 chunk,答案能定位到具体章节和页码;3)检索不到相关资料时明确拒答,降低大模型幻觉;4)模型、OCR、向量库全部配置化,同一套代码可适配云端 API、本地 vLLM 和不同客户的部署环境。

评论