在企业大数据平台建设、数据湖架构验证及数据处理系统开发过程中,需要部署和集成多种基础设施组件,包括分布式计算引擎、数据存储系统、元数据管理服务和容器化运行环境。
不同组件之间涉及网络通信、服务发现、存储协议、元数据访问、认证授权和运行环境配置等问题,容易出现组件无法连接、数据路径不一致、存储访问异常及服务运行失败等情况。
本项目面向大数据平台开发测试和技术验证场景,围绕 Hadoop HDFS、Spark、Hive Metastore、Iceberg、Gravitino、MinIO 等组件,开展环境部署、参数配置、组件集成、数据存储对接及故障排查,形成可复现的大数据基础设施实验环境。
1. 大数据组件部署:支持 Hadoop HDFS、Spark、Hive Metastore、Iceberg、Gravitino 等组件的安装、基础配置、服务启动及运行状态检查。
2. 分布式存储对接:配置 HDFS 存储路径、客户端参数及文件系统访问方式,验证数据读写和服务连通性。
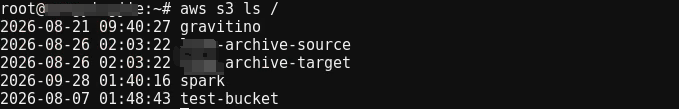
3. 对象存储集成:配置 MinIO S3 兼容接口、存储桶、Endpoint 和访问参数,开展对象存储访问测试及连接问题排查。
4. 数据湖表管理:配置 Spark 与 Iceberg 的集成环境,使用 Spark SQL 进行数据库、数据表创建及数据读写验证。
5. 元数据服务集成:部署和配置 Hive Metastore、Gravitino 等元数据管理组件,验证 Catalog、Schema、Table 等元数据管理和访问流程。
6. 容器化环境支持:利用 Docker、containerd、Kubernetes 部署和管理实验环境,配置容器镜像、环境变量、网络及目录挂载。
7. 故障排查与技术支持:针对服务启动失败、端口连接异常、依赖冲突、存储认证失败、Spark 作业异常和容器运行故障进行分析与处理。
本项目为个人大数据基础设施技术实践,主要负责 Linux 环境搭建、大数据组件部署、服务配置、存储系统对接、组件集成验证及常见故障排查。
技术环境:Ubuntu、Hadoop 3.3.6、HDFS、Spark 3.5、Hive Metastore、Apache Iceberg、Apache Gravitino、MinIO、Docker、Kubernetes、Shell。
1. 基础环境部署:在 Ubuntu Linux 环境中配置 Java、Hadoop、Spark 等运行依赖,处理环境变量、组件依赖和网络连接问题。
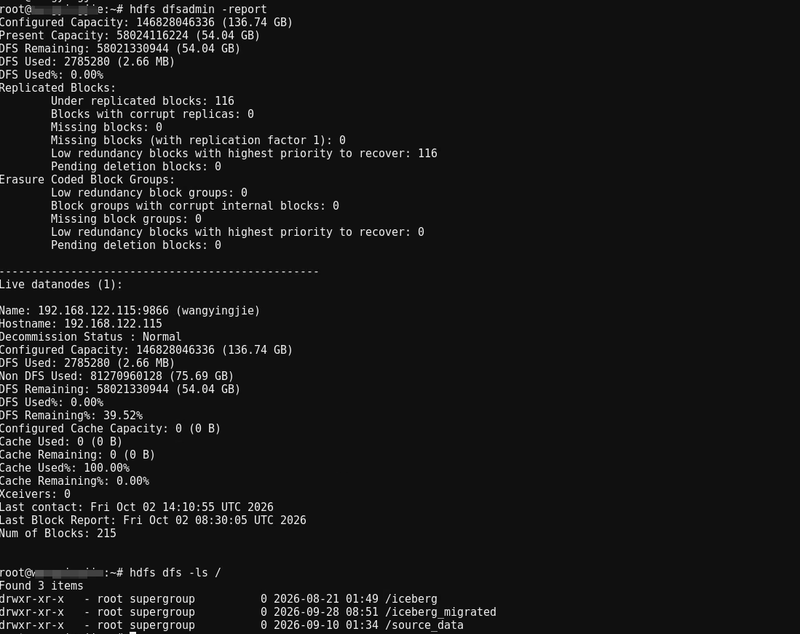
2. HDFS 存储配置:部署 Hadoop HDFS 单节点实验环境,配置 NameNode、DataNode、SecondaryNameNode、存储目录及客户端参数,验证 HDFS 服务和文件系统访问。
3. Spark 数据处理集成:配置 Spark SQL 运行环境,对接 Hive Metastore 及 Iceberg Catalog,完成数据库和数据表创建、数据写入、查询及 JOIN 等操作测试。
4. 元数据管理集成:部署 Apache Gravitino,配置 Metalake、Catalog 等元数据对象,验证 Gravitino Spark Connector 与 Hive Catalog 的集成及数据表访问。
5. 对象存储对接:配置 MinIO S3 兼容接口和存储访问参数,开展存储桶访问、客户端连接及认证问题排查。
6. 容器化部署:搭建 Kubernetes 单节点实验集群,配置 containerd、Flannel 网络插件,使用 YAML 管理 Pod 的运行环境、环境变量和宿主机目录挂载。
7. 问题排查:针对组件启动异常、HDFS 连接失败、Spark 运行异常、存储接口访问错误、容器镜像拉取失败和 Pod
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论