

1.立项原因:解决企业内部海量非结构化文档(如古籍文献、PDF规范、财务报表)格式复杂、解析困难,以及通用大模型在垂直领域回答时经常出现“幻觉”和缺乏专业深度的问题。
2、业务背景: 在中医大健康、金融合规审查等对知识精度要求极高的垂直领域。企业拥有大量经典典籍(如《中医方剂大辞典》)和内部规范,需要通过先进的检索增强生成(RAG)技术,打造可溯源、高精度的专属私域知识库。


点击空白处退出提示



1.立项原因:解决企业内部海量非结构化文档(如古籍文献、PDF规范、财务报表)格式复杂、解析困难,以及通用大模型在垂直领域回答时经常出现“幻觉”和缺乏专业深度的问题。
2、业务背景: 在中医大健康、金融合规审查等对知识精度要求极高的垂直领域。企业拥有大量经典典籍(如《中医方剂大辞典》)和内部规范,需要通过先进的检索增强生成(RAG)技术,打造可溯源、高精度的专属私域知识库。
本系统提供从多模态数据摄取到精准重排序的全链路 RAG 解决方案。
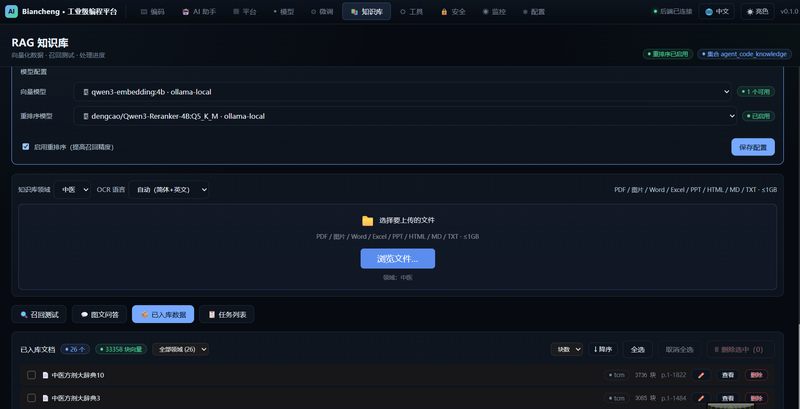
核心功能包括:1. 多模态解析与向量化:支持 PDF、图片、Word 等全格式上传,内置自动 OCR 语言识别(简体+英文),并自动完成文档分块与向量化入库(支持数万级块数的管理)。
2. 高精度重排序(Rerank):集成并支持热切换如 Qwen3-Reranker-4B 等先进重排序模型,开启后可极大提升检索片段的召回精度。
3. 多领域知识库隔离:支持按“中医”、“金融”等不同领域建立独立知识域,避免不同业务线数据相互干扰。
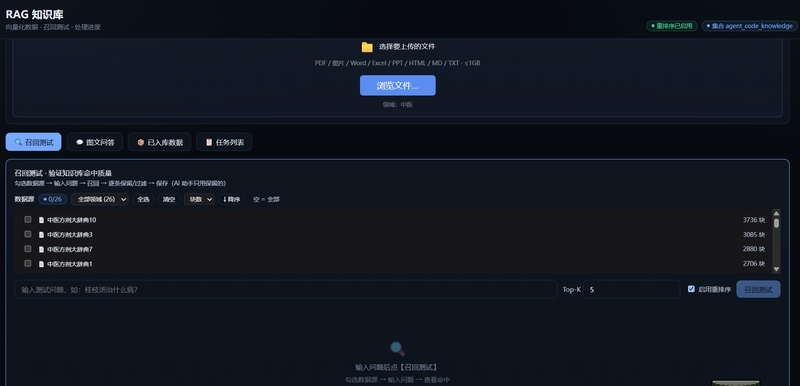
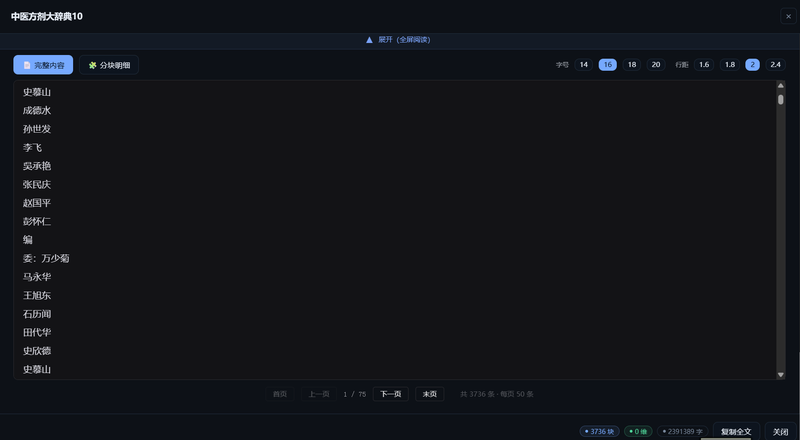
4. 全链路可视化运维:提供召回测试、图文问答、任务进度查看及已入库数据的细粒度管理(如块数统计、分页查看与删除)。
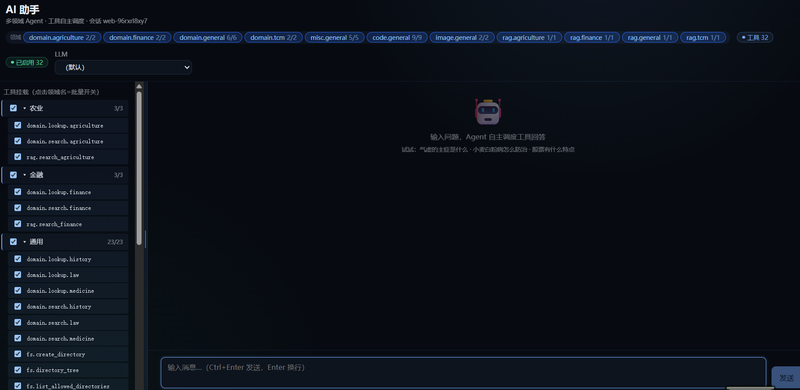
具体任务:我主要负责该平台核心的Agent 调度引擎与 RAG 检索管线的后端架构与接口开发。在 Agent 侧,实现了基于 WebSocket 的流式会话管理、多领域工具(如 domain.*、fs.*)的注册与动态挂载机制;在 RAG 侧,设计并实现了文档解析流水线(含 OCR 调度)、切片存储(对接 Qdrant),并主导接入了 Qwen3-Reranker 重排序模型,完成了知识库前端界面的全量数据交互接口。
技术栈与架构: 后端基于 Python/FastAPI,前端采用现代化组件库;引入 Ollama 进行本地大模型(LLM)的部署与调度;使用 Qdrant 作为向量数据库;构建了基于异步任务队列的文档解析架构。
亮点与难点:
难点: 复杂领域工具的自适应调度与模型精度调优。多工具挂载时,大模型容易出现工具调用幻觉或死循环;同时,中医等垂直领域的专业词汇导致普通向量检索召回率低下。解决方案:设计了严格的工具上下文隔离机制,并在 RAG 检索后置阶段,引入 Qwen3-Reranker-4B 模型进行交叉编码重排,通过调整 Top-K 参数,使业务问答的准确率得到质的飞跃。
亮点: 实现了全流程的“可视化”与“自助化”。无论是 Agent 工具的批量勾选启用,还是 RAG 知识库的“块级”数据预览、召回测试,均提供极其流畅的 Web 交互,极大降低了企业用户的配置门槛,做到了开箱即用。

评论