

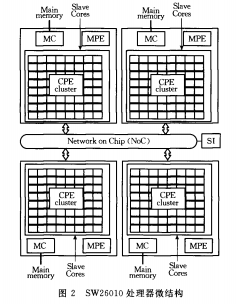
国产超算普遍采用异构众核架构,不同厂商芯片的指令集、存储层次和线程模型差异大,应用跨平台迁移需大量重写底层代码;本地编译器对异构线程、张量布局、向量通道的抽象能力不足,导致跨系统可移植性差、共性优化难复用、算子性能依赖人工调优。本项目构建统一IR及多层次优化基础设施,补充本地编译器,降低国产超算应用调优门槛。


点击空白处退出提示



国产超算普遍采用异构众核架构,不同厂商芯片的指令集、存储层次和线程模型差异大,应用跨平台迁移需大量重写底层代码;本地编译器对异构线程、张量布局、向量通道的抽象能力不足,导致跨系统可移植性差、共性优化难复用、算子性能依赖人工调优。本项目构建统一IR及多层次优化基础设施,补充本地编译器,降低国产超算应用调优门槛。
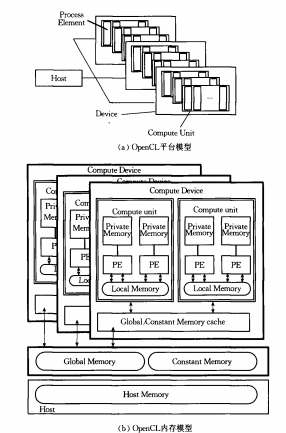
统一IR核心模块:显式表达异构线程层次、共享数据空间,统一描述线程映射、向量通道宽度与张量布局。
多层次优化模块:控制流/数据流/数据依赖融合,实现通用处理器与加速器间数据共享协同优化,支持计算与数据解耦重组。
领域IR方言模块:面向线性代数、仿射循环、不定长向量的专用方言及优化遍。
算子优化与后端映射模块(个人重点):将IR算子语义映射到国产芯片指令集与存储层次。
典型算子IR级优化验证:以SpMV、稠密矩阵乘分块核、stencil为基准,在统一IR上实施多层次优化并对比国产芯片实测性能,反馈指导IR迭代。
与本地编译器协同调试:对接国产平台本地编译器代码生成流程,解决线程模型描述不匹配、LDM重用冲突等集成问题。
技术栈:
以LLVM/MLIR为基础设施,利用多层Dialect承载统一IR与领域方言;算子优化层使用C/C++与目标芯片内建函数

评论