某头部投资咨询机构,团队十几名分析师,一年要产出上百份行业深度报告。
原来的流程是:分析师拿到选题后,先翻几十份财报、研报、新闻,手工摘数据、整理、分析、写稿、核数。一份报告要 2-3 周,光数据整理就占了一大半时间。
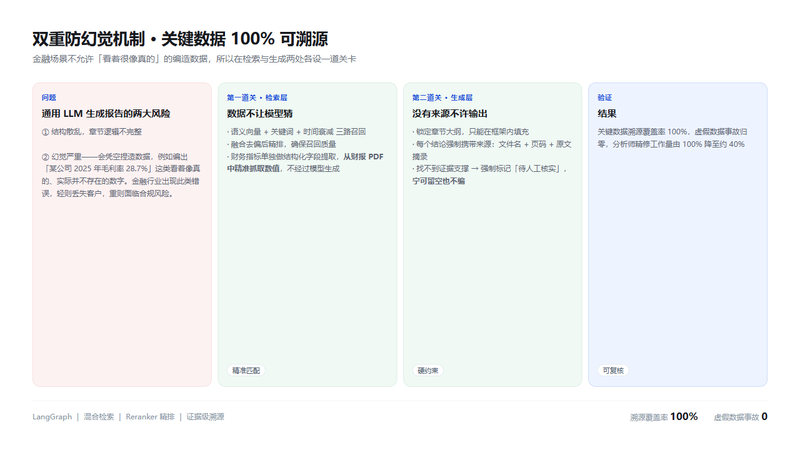
团队也试过用通用 LLM 生成报告,结果有两个致命问题:一是结构散乱,章节逻辑不完整;二是幻觉严重,会凭空捏造数据,例如编出「某公司 2025 年毛利率 28.7%」这种看着很像真的、实际并不存在的数字。金融行业一旦出现这类错误,轻则丢失客户,重则面临合规风险。
所以项目的核心目标就三件事:结构要有章法、数据必须能溯源、生成速度要提上去。让分析师从「从零写」变成「审稿和精修」。
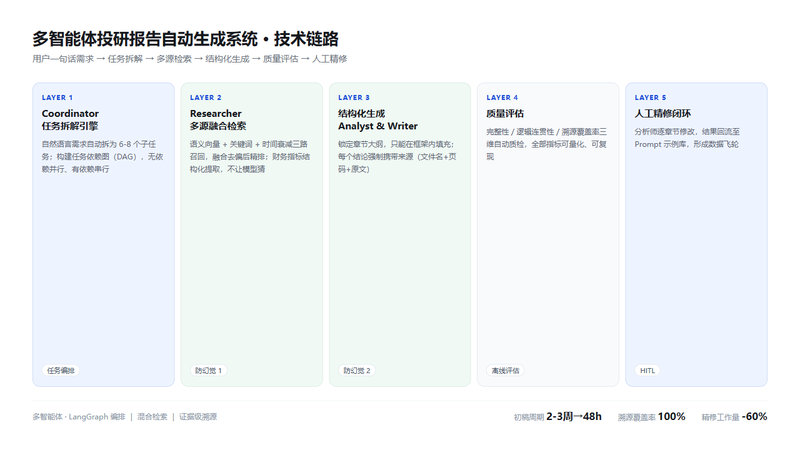
系统按一条完整链路设计:用户提出需求 - 任务拆解 - 多源检索 - 结构化生成 - 质量评估 - 人工精修。共六个核心模块:
一、Coordinator 任务拆解引擎
接收「撰写某行业报告」这类自然语言需求,自动拆解为 6-8 个子任务(宏观环境 - 市场规模 - 竞争格局 - 财务对比 - 风险提示),并构建任务依赖图(DAG),无依赖的节点并行执行、有依赖的串行流转。
二、Researcher 多源融合检索
三路同时召回:语义向量检索、关键词检索、时间衰减加权(越新的数据权重越高);三路结果融合去偏后再精排。财务指标单独做结构化字段提取,从财报 PDF 中精准抓取营收、净利润、毛利率等数值,不让模型猜。
三、结构化生成
锁定章节大纲,生成内容只能在框架内填充;每个分析结论强制携带来源信息(文件名 + 页码 + 原文摘录);找不到证据支撑的位置强制标记「待人工核实」。
四、质量评估
自动检查完整性(章节是否齐全)、逻辑连贯性、溯源覆盖率(带来源的结论数除以总结论数)。
五、人工精修闭环
分析师逐章节修改,修改结果自动回流到 Prompt 示例库,形成数据飞轮。
六、数据持久化与监控
缓存 + 关系型数据库存储,监控生成任务的 QPS、成功率、延迟分布(P99)。
我在这个项目里负责 AI 应用开发的核心部分,主要是三块:
1. Coordinator 任务依赖拆解引擎(约 500 行)
基于 LangGraph 的 StateGraph 把自然语言需求拆成 6-8 个子任务,并设计并行调度器——无依赖节点同时分发、有依赖节点串行流转。代码量不大,核心难点在状态机设计,不是堆代码。
2. 多源召回 + 财务指标精准对齐(约 400 行)
语义向量检索、关键词检索、时间衰减权重三条腿走路。最花心思的是财务指标处理——不能让大模型去猜数值,我单独设计了一套结构化字段提取方案,从 PDF 表格和文本中精确提取营收、净利润、毛利率等指标,再做文本对齐。
3. 证据级溯源机制(约 300 行)
在生成层的 Prompt 里做硬约束:没有来源的结论不许输出。同时搭建了完整性、逻辑连贯性、溯源覆盖率三维评估体系。
技术栈:LangGraph / LangChain / FastAPI / 向量数据库 / 嵌入模型 / 重排模型 / 大语言模型 / PostgreSQL / Redis / Docker / Prometheus / Grafana
踩过的三个坑:
· 幻觉防不胜防——检索到了正确数据,模型为了「写得顺」会自己加原文没有的修饰,例如凭空补一句「同比增长 15%」。最后靠溯源硬约束才拦住。
· 并行调度容易死锁——早期用普通条件边做任务流转,任务多起来后出现循环依赖直接卡死。后来把任务状态和依赖计数分开维护才解决。
· 质量评估太主观——早期用 LLM 打分,今天 8 分明天 7 分,分析师不信。改成客观指标驱动(章节齐不齐、溯源覆盖率多少)才被接受。
声明:本文仅代表作者观点,不代表本站立场。如果侵犯到您的合法权益,请联系我们删除侵权资源!如果遇到资源链接失效,请您通过评论或工单的方式通知管理员。未经允许,不得转载,本站所有资源文章禁止商业使用运营!

下载安装【程序员客栈】APP
实时对接需求、及时收发消息、丰富的开放项目需求、随时随地查看项目状态







评论