

某社交平台的 UGC 内容(用户动态、评论、群聊)在用户量增长后爆发式增加,人工审核团队压力持续加大。
审核这件事两头都不能错:漏放违规内容有合规风险,误封正常用户影响体验。需要一套自动分类系统先替人工完成初筛。


点击空白处退出提示



某社交平台的 UGC 内容(用户动态、评论、群聊)在用户量增长后爆发式增加,人工审核团队压力持续加大。
审核这件事两头都不能错:漏放违规内容有合规风险,误封正常用户影响体验。需要一套自动分类系统先替人工完成初筛。
一、双任务共享编码模型
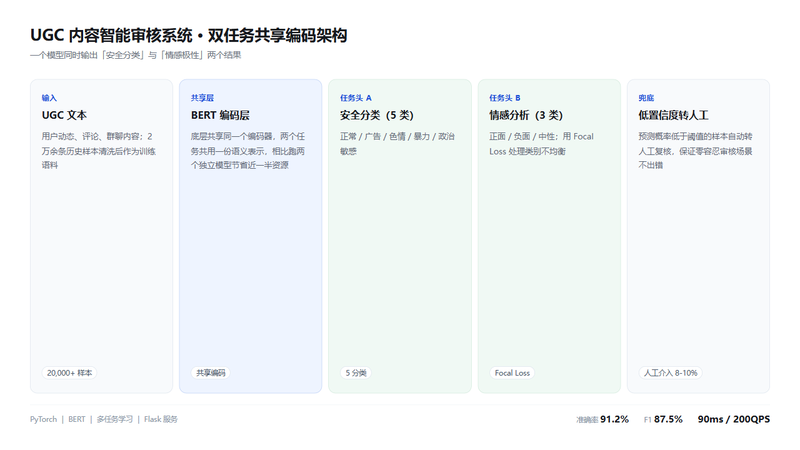
基于 BERT-base-Chinese 构建单模型多任务架构:底层共享编码层,上层分别接安全分类头(正常/广告/色情/暴力/政治敏感 五分类)与情感分析头(正面/负面/中性 三分类)。一个模型同时输出两个结果,比跑两个独立模型节省近一半资源。
二、推理服务
提供实时分类与批量审核两类接口,分别针对单条低延迟与批量高吞吐两种使用场景。
三、低置信度兜底
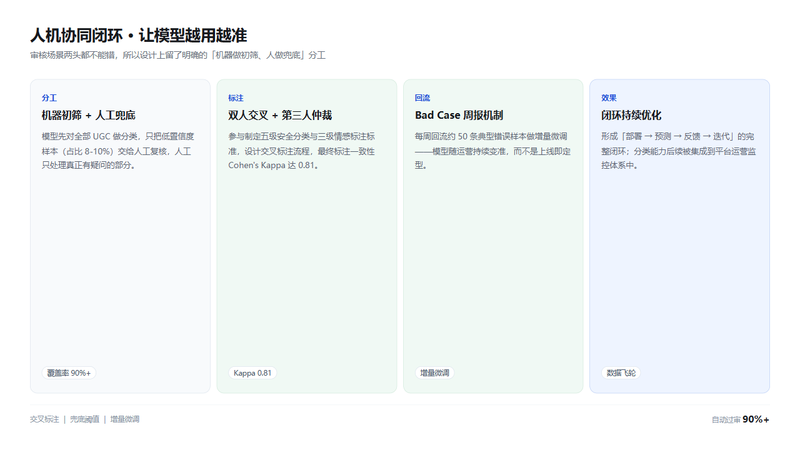
预测概率低于阈值的样本自动转人工复核,保证零容忍审核场景不出错。
四、Bad Case 回流闭环
每周回流一批典型错误样本做增量微调,模型持续优化。
这是我的第一个完整 AI 落地项目,在技术负责人指导下承担了模型训练与工程部署的全部开发执行工作:
1. 数据与标注规范
参与制定五级安全分类和三级情感标注标准,设计双人交叉标注 + 第三人仲裁的流程,清洗 2 万余条历史样本,最终标注一致性(Cohen's Kappa)达到 0.81。
2. 模型微调
设计双任务共享编码层架构,调参包括多任务损失配比、学习率预热与线性衰减、早停策略;情感分析任务用 Focal Loss 处理类别不均衡。
3. 推理服务与兜底机制
搭建推理服务并完成容器化部署,实现低置信度自动转人工的兜底逻辑。
技术栈:Python / PyTorch / HuggingFace Transformers / BERT / Scikit-learn / Flask / Docker
踩过的三个坑:
· 类别不均衡——违规样本远少于正常样本,直接用交叉熵会让模型偏向多数类。情感分析改用 Focal Loss 后明显改善。
· 多任务互相干扰——两个任务的损失权重需要反复调整,一个权重太大另一个就学不好。
· 兜底阈值定多少——定高了人工压力大,定低了风险高。最后按业务能承受的人工介入率反推。

评论