

高噪声情况下的端侧实时语音指令识别,在机场,铁道等高噪声场景下,实现基于赛灵思开发板的高精度,多指令,可扩展,高鲁棒的语音指令识别模型。

点击空白处退出提示
高噪声情况下的端侧实时语音指令识别,在机场,铁道等高噪声场景下,实现基于赛灵思开发板的高精度,多指令,可扩展,高鲁棒的语音指令识别模型。
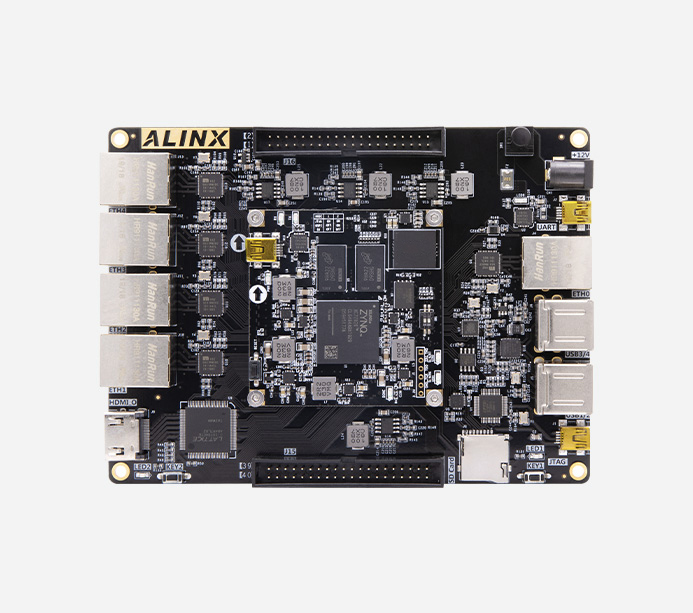
端侧实时语音指令识别:负责算法设计与软件开发,完成模型训练、ONNX优化、C++解码及设备部署。在项目测试条件下,信噪比-5~15dB时识别准确率超过95%,响应延迟低于200ms。
负责语音指令识别算法设计与软件开发,完成从数据整理、模型训练到端侧部署及性能验证的完整流程。
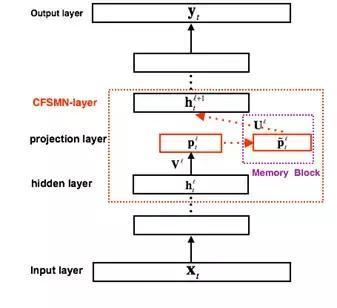
1. 数据与模型开发:融合自采集语音与公开数据,构建指令识别训练及测试数据集。基于dFSMN与CTC设计轻量化语音识别模型,利用时序上下文建模完成语音特征到识别序列的映射,并在不同信噪比条件下评估识别效果。
2. 模型导出与推理优化:完成模型ONNX导出及推理优化,验证导出前后的输出一致性,结合目标设备的计算资源和实时响应要求,对模型推理与解码链路进行性能分析和优化。
3. C++解码与设备集成:使用C++实现CTC前缀束搜索解码,将模型输出转换为指令识别结果,完成模型推理、解码程序与端侧运行环境的集成,打通音频输入到指令输出的完整识别链路。
4. 测试与成果交付:完成目标设备部署及不同噪声条件下的识别准确率、响应延迟测试,验证端侧运行效果,形成可运行的语音指令识别算法模块及配套部署程序,为设备语音交互提供技术基础。

评论