Python

Python是一门诞生于1991年的高级、解释型编程语言,由吉多·范罗苏姆创造。其核心设计哲学强调代码的极简性和可读性,尤其依赖清晰的缩进来定义代码结构,这使得它语法接近英语,非常易于学习和使用。作为动态类型语言,它为快速开发和原型设计提供了极大的灵活性,并支持面向对象、命令式、函数式等多种编程范式。Python的巨大优势在于其拥有一个由庞大活跃社区支撑的丰富第三方库生态系统(PyPI),覆盖了几乎所有应用领域:无论是Web开发(Django, Flask)、数据科学(Pandas, NumPy, Matplotlib)、人工智能(TensorFlow, PyTorch)还是自动化脚本和系统运维,都能找到成熟高效的工具库。这种“开箱即用”的特性使其成为解决各类实际问题的“瑞士军刀”,兼具强大的功能与简单的语法。
Python语言框架
Python是一门诞生于1991年的高级、解释型编程语言,由吉多·范罗苏姆创造。其核心设计哲学强调代码的极简性和可读性,尤其依赖清晰的缩进来定义代码结构,这使得它语法接近英语,非常易于学习和使用。作为动态类型语言,它为快速开发和原型设计提供了极大的灵活性,并支持面向对象、命令式、函数式等多种编程范式。Python的巨大优势在于其拥有一个由庞大活跃社区支撑的丰富第三方库生态系统(PyPI),覆盖了几乎所有应用领域:无论是Web开发(Django, Flask)、数据科学(Pandas, NumPy, Matplotlib)、人工智能(TensorFlow, PyTorch)还是自动化脚本和系统运维,都能找到成熟高效的工具库。这种“开箱即用”的特性使其成为解决各类实际问题的“瑞士军刀”,兼具强大的功能与简单的语法。
开发组织  吉多·范罗苏姆
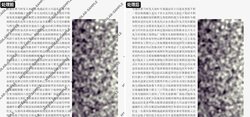
1.PDF:识别注释、图层和每页重复的文字、图片、图形水印,直接删除对象,完全无损。2.半透明水印:估计透明度和颜色后反算,保留底下的真实纹理。3.铺满全图的重复水印:自动找出重复规律,多处样本联合估计,不用手动标记。4.扫描件铺满水印:逐条定位,页边纸面弯曲处逐段贴合,压在正文和照片上的也能去掉。
170Python音视频多媒体
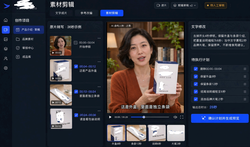
1.品牌资料与创作策划。建立产品档案,集中管理已审定的产品信息、包装素材和禁用表述。根据创作目标生成研究简报及多套选题方案,保留公开资料的来源和访问时间,供团队筛选、改写并确认。2.AI成片与参考视频改编。输入文字需求即可发起单条或批量制作,生成脚本、画面、配音和字幕并合成成片。也可批量上传有权使用
200Python人工智能
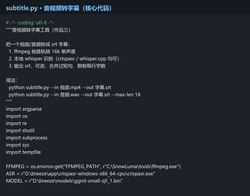
导入一个视频或音频,自动分离音轨并统一采样率,用本地模型识别成文字,再按语义重新切句、压到每行不超过二十来个字,导出srt。可以一次丢多个文件进队列,输出文件名跟源文件对应,剪映、PR直接导入就能用。不联网,素材不外传。
390Python音视频多媒体
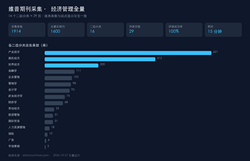
1)分类导航:解析站点分类树,自动识别35个一级分类,支持指定一级分类或只采某几个二级分类;2)列表翻页:按每个二级分类逐页请求(每页100条),从隐藏域读取总数自动算页数,保证不漏页;3)详情采集:按期刊唯一ID抓取整页详情,10并发,跨分类重复期刊只抓一次;4)字段解析:输出28列,含主办/主管
910Java科学研究
核心功能01 数字人形象:一张照片就能开口说话上传一张人像照片,即可生成可驱动的数字人形象;也支持短视频素材。形象统一入库管理,一次登记长期复用。-支持「自然眨眼」模式,画面不是一张僵住的图-多个形象并存,不同内容用不同人设-形象卡片可直接「用于生成」,不必再翻素材目录形象素材02 声音克隆:10–
670Java音视频多媒体
桌面自动化产品系统
自动录入或修改系统数据内容自动录入或修改系统数据内容自动录入或修改系统数据内容自动录入或修改系统数据内容自动录入或修改系统数据内容自动录入或修改系统数据内容自动录入或修改系统数据内容
760Python脚本插件
项目围绕AI短剧制作全链路设计,包含项目、章节和镜头管理,AI剧本处理可将长剧本自动拆分为分镜并落地到画布;资产库统一管理角色、场景、道具、服装和演员,通过参考图及语义检索为生成任务提供上下文;可视化画布支持剧本、图片、视频等节点编排与连线,多节点可批量触发生成并回写结果;模型管理支持配置多家Ope
3210Python人工智能
全自动批量关注:在搜索列表中,自动识别未关注过的用户,并精准点击“关注”按钮。自动进入主页浏览:关注后,自动打开该用户的个人主页。模拟真人下滑:进入主页后,鼠标会自动进行随机滚动,模拟真人在翻阅对方的照片和动态。自动点赞:自动寻找对方主页最新发布的帖子,并点击小红心(点赞)。全自动发私信(DM):自
910Python音视频多媒体
1.文案引擎:无APIkey走本地模板,支持LLM升级;2.TTS引擎:edge-tts8个中文音色+离线SAPI回落;3.ffmpeg合成:ASS字幕、kenburns效果、混排合成;4.数字人模块:rembg抠图+PIL口型模拟+眨眼+呼吸动画;5.多平台发布:Playwright自动化分发到抖
800Python人工智能
根据对应视频链接,抓取B站视频的相关信息(发布时间,视频时长,播放次数,评论量等信息),将抓取的结果保存到本地.........................
780Python脚本插件
伪造声音检测产品系统
澄声是一套可本地离线运行、具备可解释证据链的AI深度伪造语音检测平台,核心采用自研镜像孪生(MirrorTwin)检测范式,依托Mimi音频编解码器,对上传语音进行真伪判别,输出置信度、检测分数与溯源证据,解决当前AI声音克隆诈骗、录音篡改、虚假舆情音频难以核验、判定无依据的痛点。系统支持WAV/F
1330Python音视频多媒体
OpenLucky开源项目
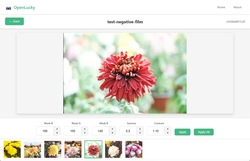
OpenLucky是一款面向胶片摄影爱好者的轻量级开源彩色负片去色罩与图像校正工具,基于OpenCV实现,旨在简化彩色负片数字化后的色彩校正流程。软件内置多种胶片预设,支持色罩RGB通道、伽马、对比度、曝光及白平衡等参数调整,并提供实时预览、直方图分析与批量处理功能。项目同时提供基于Electron
1690Python音视频多媒体
三大核心模块:1.文字生产线:llama.cpp三档模型加载器(快/均衡/质量),8090-8092三端口隔离,流式逐字输出带进度字数;内置短剧7类预设任务(开场旁白、人物小传、分镜脚本、标题钩子、反转钩子、金句、结尾收束),多轮对话上下文记忆,输出层sanitize处理剥助手腔、多版本收敛。2.图
1090C++内容平台
屏幕录制产品系统
1,需要有操作界面,可以选择录制的原图、录制的画面、录制的声音、录制的文件2,支持录制视频动态,尽量保持跟视频同步3,支持录制声音声音的源头可以是系统播放或者是麦克风4,支持多个分辨率格式保存
730Java音视频多媒体
基于Wav2Lip模型开发的音频驱动数字人唇形同步工具,输入单张人物图片与语音音频,即可自动生成口型与音频精准匹配的数字人说话视频,人物眉眼、头部等其余面部区域保持自然静态,适用于短视频制作、数字人播报、课程配音、虚拟解说等场景。1.核心算法:基于GAN生成对抗网络架构,通过提取音频梅尔频谱特征驱动
2540Python开发工具
系统包含四大核心模块:1)内容监听与抓取:支持TikTok等海外平台按关键词或指定账号进行自动扫描监听,实时发现热门视频并批量下载,支持增量更新和去重过滤;2)视频智能去重:基于FFmpeg的多层处理流水线,包含帧率调整、色彩矩阵变换、轻微随机裁剪、音频重采样、HDR转SDR等手段,生成平台无法识别
1440Python音视频多媒体
1)剧本结构化:解析场次、人物、动作与状态,形成可机读的场景/镜头骨架。2)分镜资产生成:按镜输出镜头定义、连续性描述与语义状态(不只是一段文案)。3)多渲染器提示词:针对不同图像/视频模型生成可切换的提示词与参数建议,避免一套prompt绑死一家模型。4)批量任务:整本剧本批量出分镜、批量重跑失败
1770Python内容平台
全链路实时语音:麦克风WebRTC采集→SileroVAD(含500ms预回填,降低开口丢字)→流式STT→LLM流式生成→流式TTS→WebAudio播放;说话即打断(barge-in),用户插话立即停生成、停发声并重新监听,无需等AI说完。Provider中立:STT/LLM/TTS统一接口,1
1580Python人工智能
1.拍摄与上传:提供桌面操作界面,支持相机画面预览、拍摄控制、持续上传及处理进度查看。2.本地视频分析:支持导入已拼接的全景视频或普通视频,开展候选片段提取和高光分析。3.人物检测与场景分区:检测视频中的人物,根据人物位置划分候选场景,从全景画面中提取适合分析的视角。4.多模型高光评审:调用多模态大
1431Python音视频多媒体
灵镜是Windows桌面动态壁纸引擎,坚持本地优先、零账户、无广告。三区布局:左侧侧栏、中间壁纸网格、右侧详情抽屉,底部控制条可切播放/音量/循环。支持视频与动图壁纸,拖拽导入本地批量管理;多显示器分三种分配方式。全屏或游戏时自动暂停至0%占用,电池模式自动休眠,按类型分性能档。收藏、主题切换全本地
1180Python音视频多媒体
当前共97个项目more
×
寻找源码
源码描述
联系方式
提交